AI强化学习算法白话版:训练AI像训小狗一样
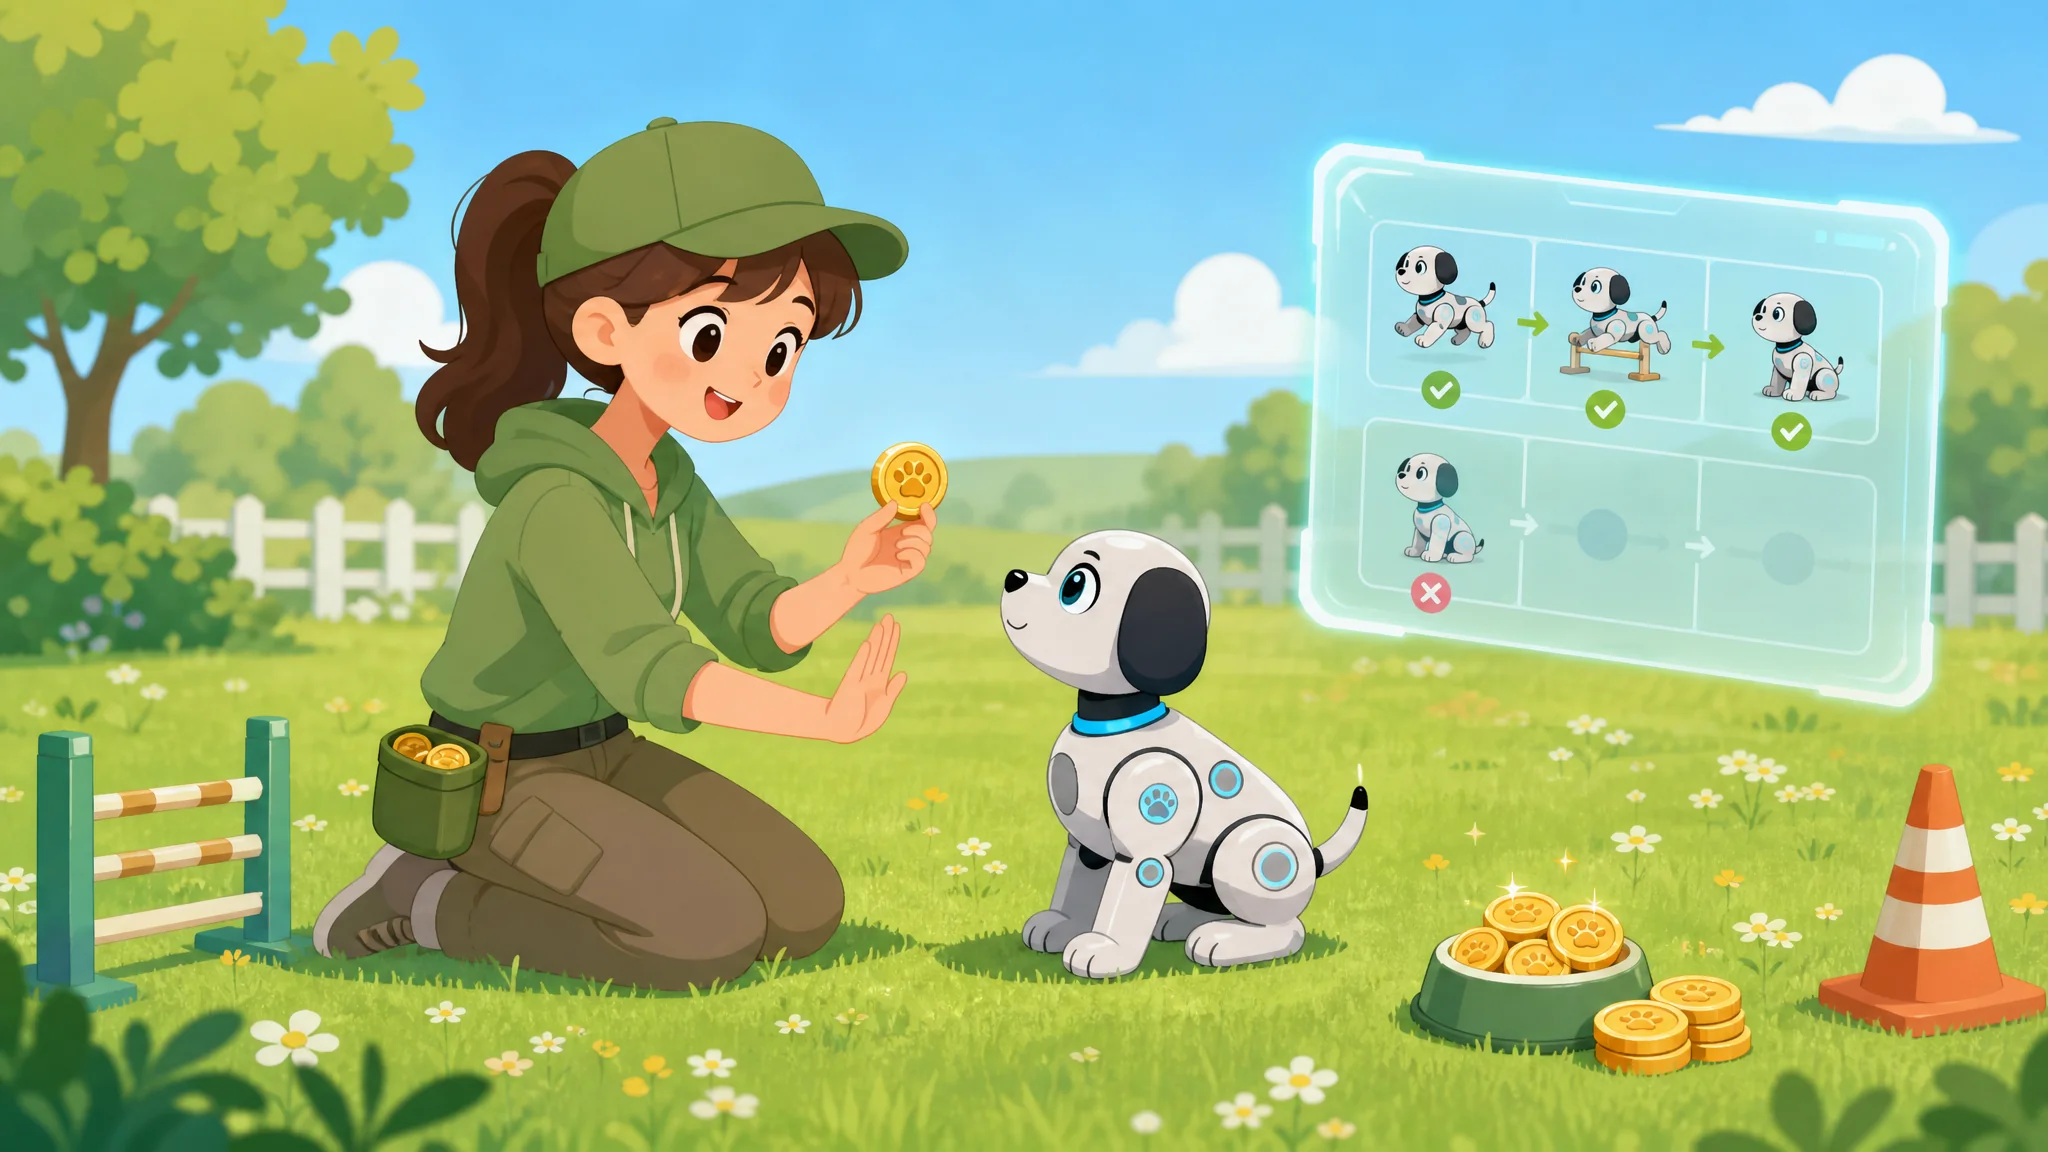

简单说:AI强化学习计算法的核心就一句话——做对了给糖,做错了没收玩具。AI在反复试错里自己摸索出哪套动作能拿到最多奖励,人只负责定奖励规则,不教具体步骤。想入门别啃公式,先跑通一个小环境,一晚上就能建立直觉。
第一次听人讲AI强化学习计算法,我全程懵。状态、动作、策略函数,一堆词砸过来,笔记记了三页,合上本啥也没剩。转折发生在我家那只泰迪身上——那阵子我正教它握手,突然反应过来:我根本没给它写过任何“抬起右爪”的说明书啊,我只是它做对了就给零食,做错了就没收。它自己试出来的。诶,这不就是强化学习吗?后来我照着这个思路重学了一遍,再用Gymnasium跑了个最简环境,整个逻辑一下就通了。这篇文章就按“训小狗”这条线,把强化学习从头捋给你看,包括我跑第一个环境时出的洋相。
AI强化学习计算法到底在算什么:三个角色对上号
它在算一件事:给定当前局面,选哪个动作,长期拿到的奖励最多。整个过程只有三个角色——小狗、动作、零食。翻译成术语再对一遍号,你就能看懂大多数教程了:小狗叫“智能体”(Agent),它面对的局面叫“状态”(State),它干的每件事叫“动作”(Action),零食叫“奖励”(Reward)。训小狗时你不会教它肌肉怎么发力,强化学习也不告诉AI具体步骤,只给它一个打分规则,让它自己撞。撞一万次之后,它心里形成一套“什么局面干什么事”的习惯,这套习惯就叫“策略”(Policy)。
注意一个容易忽略的点:奖励是即时的,目标却是长期的。小狗这口做对了有零食,但我们真正想要的是它一辈子见人就握手。强化学习里专门有个词管这个,叫折扣因子,意思是“十步之后才能拿到的奖励,现在只算它七折”。为啥要打折?因为未来的事不确定,先把眼前的糖攥住。这跟人做事的逻辑挺像,不见得高尚,但好用。
训小狗的四个环节,对应强化学习的四步循环
观察、行动、打分、更新习惯,这四步转一圈就是强化学习的全部流程,转上几千圈,狗就训成了。我把它跟训小狗一一对给你看。第一步观察:小狗看到你伸出手(状态)。第二步行动:它随便抬了个爪子,或者原地坐着不动(动作)。第三步打分:抬对了给零食,抬错了没反应甚至被按回去(奖励或惩罚)。第四步更新:它脑中“伸手→抬爪→有吃的”这条连接变强一点(策略更新)。然后下一轮开始。强化学习算法干的就是这件事,只不过AI一轮的耗时可能只有几毫秒,一晚上能转几十上百万圈。
这套循环里最贵的其实是第三步——设计奖励。我后面会专门讲,奖励设计歪了,AI学出来的东西能让你笑出声。
插一段我自己的翻车记录。今年四月底,我决定亲手跑一个最简环境CartPole:一根杆子立在小车上,AI控制小车左右移动,别让杆子倒。听着简单吧?我第一次写奖励函数,嫌官方的打分规则太平淡,自己加码——杆子每活一步给1分,我还额外给了个“小车位置居中”的奖励,觉得这样它学得更稳。跑了三个小时,杆子是没倒,但小车以肉眼可见的速度滑向屏幕边缘,一路顶到最右边再也没回来。哈哈,AI学会的是“往边上蹭位置分”,不是我想要的“稳住杆子”。我愣了得有十秒才反应过来:它没毛病,是我的零食发歪了。奖励函数就是训狗人手里的零食袋,你怎么发,它怎么长。这十分钟的教训,比我看十篇教程都记得牢。
探索和利用:小狗为什么有时候不听话
强化学习里最经典的纠结——是该照老经验拿稳拿的零食,还是去试试新动作万一有更大的肉?术语叫探索与利用的平衡。你家小狗明明会握手了,有时候你伸手它却躺下打滚,别急着骂它,它可能是在试探“打滚是不是有更大的零食”。算法里管这个叫epsilon-greedy(ε-贪婪)策略:设一个比例,比如10%的概率随机乱来,90%的概率按目前最优习惯走。训练初期乱来的比例调高,多摸情况;训练后期调低,安心吃熟练的。我跑CartPole时这个值从1.0一路衰减到0.05,前期满屏乱晃,后期动作肉眼可见地“稳”了下来——那个变化瞬间,说实话比我第一次看懂公式激动多了。
顺带说个有意思的对照:监督学习像对着标准答案刷题,错一道改一道;强化学习没人给你标准答案,只有糖和没糖。想知道这两条路线的全景区别,可以看我之前写的监督式学习白话讲解,放一起看更清楚。
价值函数和Q表:小狗心里那本“零食账”
价值函数就是小狗心里的账本:记着每个局面跟着某个动作,长远能攒多少零食。账本厚了,遇事翻账本就行,不用再瞎试。最直白的实现叫Q表(Q-table),一张二维表格,行是状态,列是动作,格子里填“这么干以后总共能捞多少分”。训练过程就是不停刷新这张表:试一次,回来把这条格子的估值修一修,术语叫时序差分,说白了就是“根据这次结果修正预期”。格子越多,表越大。CartPole的状态是连续的(位置、速度、角度、角速度都是小数),格子根本列不完,所以才有了深度强化学习——用神经网络代替表格来记这本账,DeepMind当年用它让AI打 Atari 游戏超人类水平,靠的就是这套。想看更底层的关系,可以延伸读这篇深度学习白话入门,神经网络其实就是个会记复杂账本的“狗脑子”。
AI强化学习计算法最要命的坑:奖励设计
算法不出错的时候,错的大多是奖励函数。奖励写歪了,AI会以你想象不到的认真劲儿去钻空子。这类翻车在圈子里有个专门的名号,reward hacking。真实案例一抓一把:有研究发现,一个在水面清理虚拟垃圾的强化学习小船,学会了反复把垃圾推到看不见的角落刷分;训练机械臂抓球的AI,学会直接把球拍到摄像头够不着的地方——它拿到的分数照样很高。跟我的CartPole翻车一个道理:你不想要的捷径,只要能得分,它就敢走。所以圈内人的共识是,强化学习项目里花在调奖励上的时间,经常比写模型本身还多。这话一点不夸张,我的小实验里奖励项改了六版才消停。
所以入这行前先掂量下性格。你要是没耐心跟一个“故意”装傻的程序耗,这方向会磨人;可你要是享受那种“它终于学会了”的瞬间,强化学习给你的正反馈也确实上头。适不适合往深了学,可以参考这篇强化学习学了能干什么,先把出路看清楚再投入。
我的完整上手记录:一晚上跑通第一个强化学习环境
路线就四步:装Gymnasium、抄官方示例、看它瞎动、改参数看变化。总耗时约四小时,零费用,全程只用CPU。给你我的实操流水账,照抄就能跑。晚上八点开电脑,pip装好Gymnasium(OpenAI Gym的社区维护版,官方文档在gymnasium.farama.org),从CartPole-v1开始。第一步不写算法,先随机乱动跑一百回合,看杆子平均几秒倒——我的成绩是平均22步,惨不忍睹但很正常,这是“没训练的狗”。第二步上DQN算法(代码用的是网上烂大街的标准实现,两百来行),开始训练。第三步盯着回报曲线,前两百回合纹丝不动,我以为代码写错了,检查了半小时,白检查。第四百回合左右曲线突然抬头,五百回合后平均能稳住四百多步。
最戏剧的是我调用渲染把训练后的AI放出来看:杆子倒了就往倒的方向猛打车,杆子直了就微小地左右修正,稳得像个老司机。那一刻有点起鸡皮疙瘩,没任何人教过它“怎么稳”,它就是被分数逼出来的。要看更硬核的前沿成果,DeepMind的官方网站上有从AlphaGo到AlphaZero的完整论文,当年那个自学围棋四年横扫世界冠军的AI,用的就是自我对弈的强化学习,没有任何人类棋谱。喜欢游戏背景的,还可以看看我写的游戏AI强化学习入门,那篇讲了游戏里怎么用。
普通人该学到什么程度:我的三档建议
第一档看懂原理会聊天,第二档跑通小环境能改参数,第三档才轮到啃论文写算法。绝大多数人停在第一二档就够用了。我给你摊开说。第一档:把这篇文章读透,能跟人讲清奖励、策略、探索这三件事,看科技新闻不犯迷糊,够了,一周的事。第二档:跟着跑通CartPole,再换个LunarLander(月球着陆器)环境练手,能独立改奖励函数并解释结果变化,这是简历上敢写“了解强化学习”的水平,我的建议是停在这档,一到两个月。第三档:读Sutton那本《Reinforcement Learning: An Introduction》(书和代码全免费开源在MIT出版社官网),上手写算法,这一档耗时以年计,除非你想吃这碗饭,别硬啃。很多人死在“跳过一二档直冲第三档”,最后哭着退坑,我一个朋友就是这么从入门到放弃的。
常见问题
AI强化学习计算法和监督学习最大的区别是什么?
监督学习有标准答案,错了有人告诉你错在哪;强化学习没有答案,只有得分,全靠自己试。一个像刷题,一个像闯荡。也因为这个特性,强化学习更适合“步骤多、反馈晚”的任务,比如下棋和打游戏。
强化学习需要很高的数学水平吗?
入门不需要。理解奖励、状态、策略这些概念,初中数学够用。真要自己实现算法,概率和线性代数的底子得有;但只是跑环境、改参数、建直觉,一个晚上就能上手。别被公式吓退,先把狗训明白再说。
强化学习现在有哪些真实的落地场景?
最出名的是游戏和博弈:AlphaGo下围棋、OpenAI Five打Dota 2。工业上用在数据中心降温、机器人控制、广告和推荐策略的优化,大模型的RLHF(人类反馈强化学习)也属于这套思路——ChatGPT变乖,靠的就是拿人类打分当零食去训它。
学强化学习买什么硬件?显卡要求高吗?
跑CartPole这类小环境,核显笔记本就行,我用的是一台四年前的轻薄本,全程CPU,风扇都没怎么转。想上大点的图像类环境再考虑显卡,入门阶段一分钱不用花。别拿硬件当拖延的借口,我就是这么骗了自己小半年。
写到这,AI强化学习计算法这条线就算捋完了:一只小狗、一袋零食、一个记了账的脑子,剩下的交给时间。我到现在还保留着那份CartPole的训练曲线截图,偶尔翻出来看看,提醒自己最复杂的思想往往长着最朴素的模样。你要是也心动了,今晚就装个Gymnasium试试,让那根杆子替你入门。学之前不妨先看下AI学习路线怎么按目标定制,把强化学习安插在合适的位置,别一上来就 all in。
觉得这篇讲得够明白的话,转给那个总说“强化学习听不懂”的朋友,训狗这套比喻应该能救他一把。