AI是怎么被训练出来的?用AI训练AI的门道
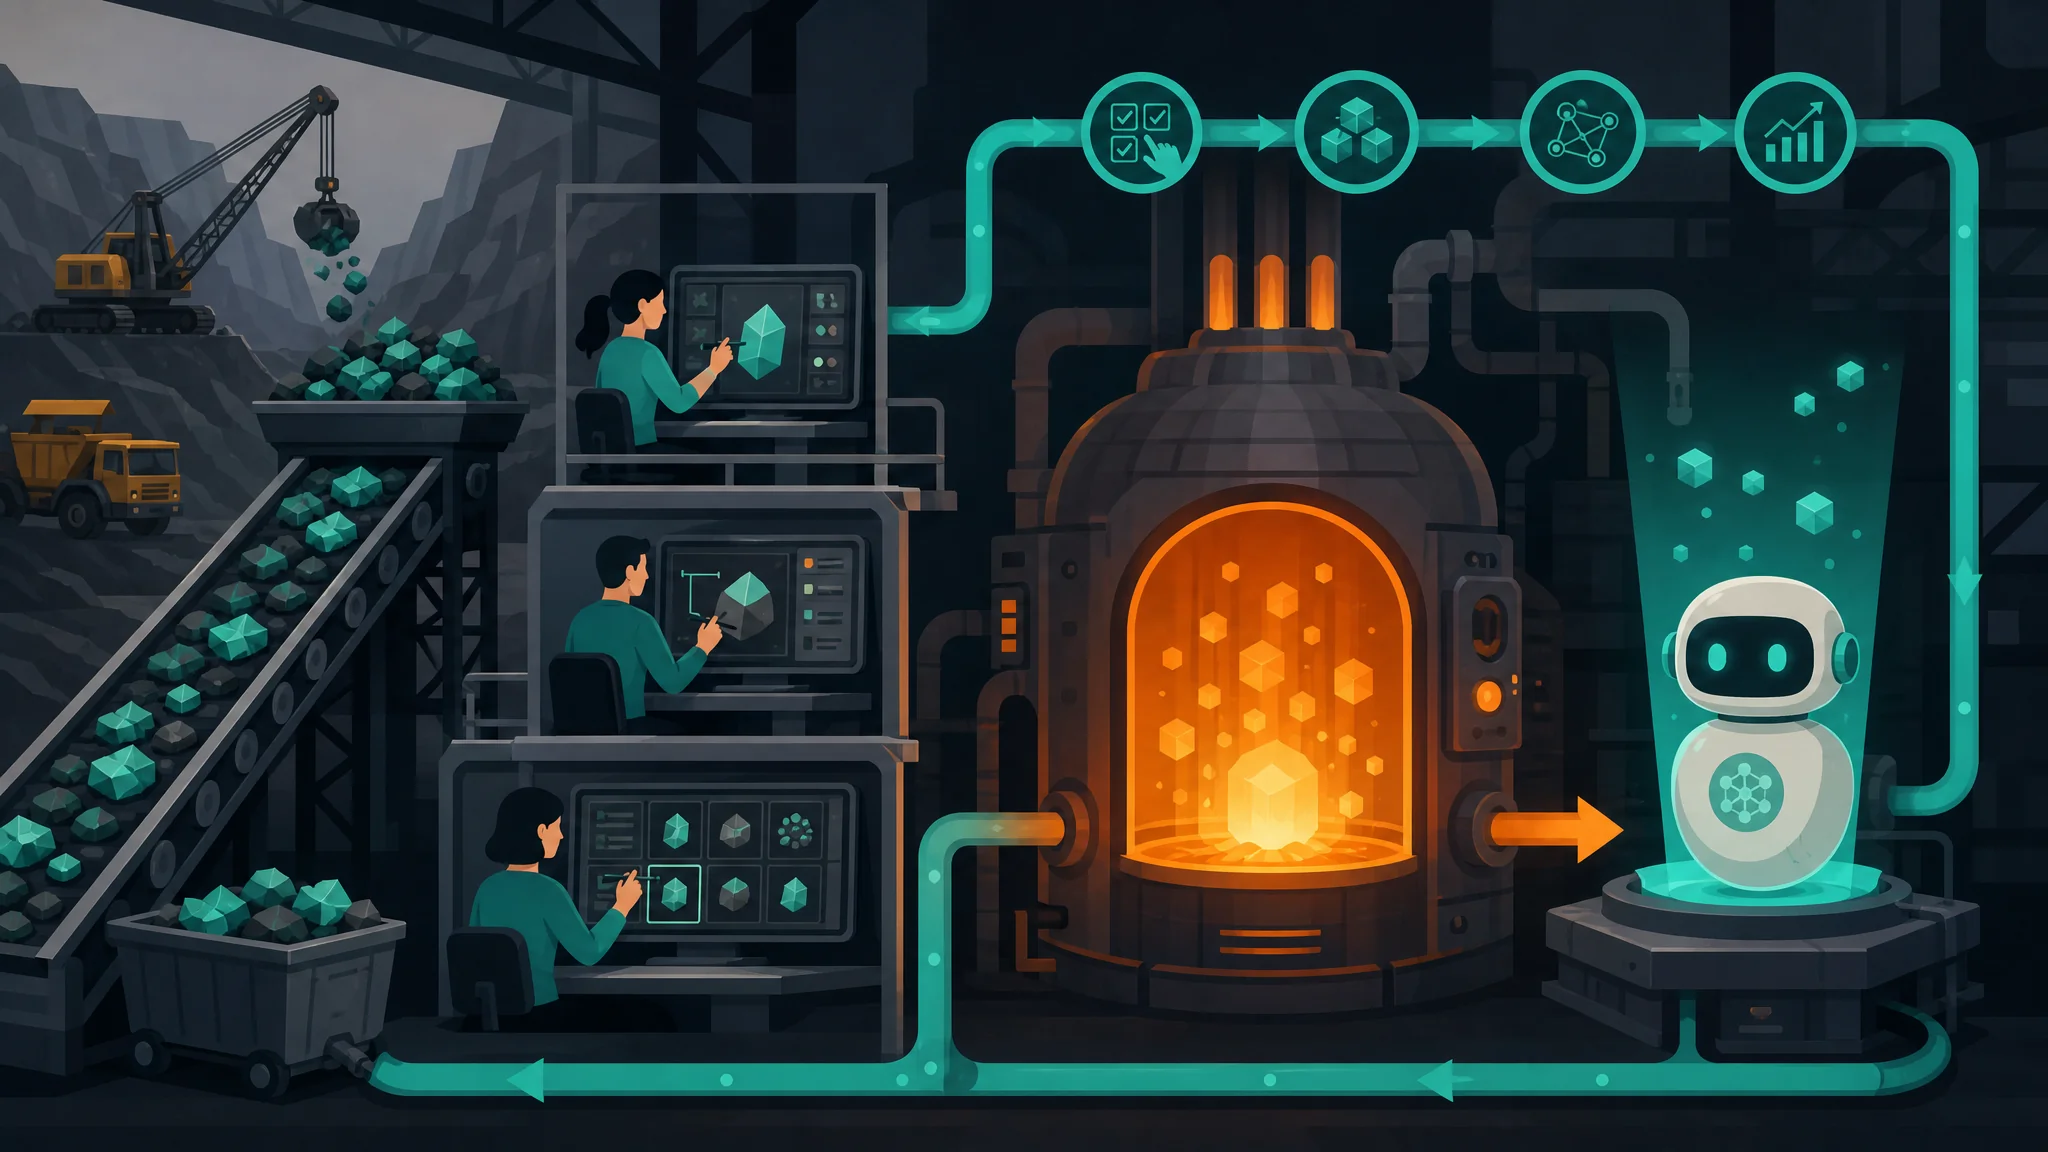

简单说:AI怎么学习AI?答案是三步——海量数据打底、人工标注定口味、微调成 Specialist。如今最火的一步是"AI训练AI":让AI生成数据、AI评判数据,人只管把关。全流程我用开餐厅给你讲透。
AI怎么学习AI这个问题,我第一次听到时以为对方口误。后来才发现这是个真问题:现在的AI训练流程里,真有一大块是拿AI来训练AI的,而且占比越来越大。这事我琢磨了很久,还专门拿一个微调小项目跑了一遍全流程,从准备数据到模型出结果,前后折腾了三周。磕磕绊绊,但跑通了。
这篇就把这条流水线掰开讲。不堆术语,全程用开餐厅打比方——这是我讲给六十岁我爸听时现场编的,他听懂了,还追问了两个问题,可见这比方能打。
第一步:数据采集,AI怎么学习AI的备菜环节?
原子答案:训练的第一步是海量数据打底,相当于餐厅进食材,互联网文本、书籍、代码都是食材,量级以万亿计的词汇打底,这一步决定模型"见没见过世面"。
餐厅要开业,先得进食材。模型要成型,先得吃数据。吃多少?公开资料显示,主流大模型的预训练语料普遍在数万亿token的量级——你可以粗暴理解为几百万本书加整个互联网的正文。我爸听到这儿问:那得多少硬盘?我算了算,光文本就得好几个PB,一个PB是一百万GB。他沉默了。
食材讲究新鲜和干净,数据也一样。我跑小项目时用的是公开的中文指令数据集,下载下来第一件事是清洗:去重、删乱码、过滤低质量内容。我的数据只有几万条,清洗完剩六成多。就这几万条,清洗脚本跑了小半天。想象一下几万亿token清洗一遍是什么工程量,我对数据工程师的敬意那天涨了三倍。
数据质量决定模型上限,这事行业里早有共识,Reddit网友手搓的OpenAssistant项目和它的坎坷经历就是最好的注脚,感兴趣可以翻Reddit上的开源社区讨论。
第二步:标注,给食材定口味的人工环节
原子答案:标注是人在训练流程里最重的参与——人写出标准示范或对答案排序,模型照着学"好答案长什么样",相当于后厨试菜定口味。
光有食材做不出招牌菜,得有菜谱。标注就是写菜谱:人对同一道题写出好答案,或者把模型的多个回答按好坏排序,模型拿着这些"标准"去校准自己。这环节有多费人?OpenAI早年雇佣过大批肯尼亚标注员处理训练数据,媒体报道时薪按美元算,工作量按年算。每一句"模型说人话"的背后,都是真人一题一题喂出来的。
我自己标注时才体会到这种苦。给我的小模型标了三百条"问答对",标到第八十多条开始怀疑人生:同一类问题换个问法,标准答案怎么写才算一致?这种主观性极强的判断,恰恰是最难被自动化替代的部分。当时我对着屏幕发了会儿呆,突然理解了为什么标注团队需要写厚厚的规范文档。
想看监督学习这个底层机制的完整拆解,监督式学习的白话讲解那篇讲得比我细,正好接上这段。
讲个我项目里的翻车。微调跑完第一版,我兴冲冲去测试,问它"推荐三部悬疑片",它回答了三部,其中两部压根不存在,片名是它编的。我爸在旁边看着,说了句大实话:"这学徒菜谱背岔了。"
一针见血。后来排查,是我训练数据里混了一批没清洗干净的影评网页,全是营销号的虚假安利。模型吃了什么,就长成什么样。数据这关把不严,后面全是白搭。
第三步:微调,学徒变主厨的专场训练
原子答案:微调是在已经训好的大模型上做定向改造,让通才变专才——相当于把全能学徒按你的菜系专门特训,成本只有从头训练的零头。
预训练出来的模型像个全能学徒,什么菜都会一点,什么都不精。微调就是挑一个方向特训。我的小项目就是给一个开源底座喂我标的那批问答对,跑了几轮,眼看着它从"泛泛而谈"变成"按我的格式答题"。耗时方面,借了云上的免费算力,断断续续跑了一个周末。
成本是真便宜。从头训一个大模型的账,业内的公开估算动辄数百万美元起步,英伟达靠AI训练芯片赚得盆满钵满也是公开信息,英伟达官网的产品页能看出这生意的规模。而微调用消费级显卡就能起步,普通爱好者摸得起。这也是为什么这两年"人人都能微调一个小模型"成了潮流。第一次看到自己微调的模型说出"人话"时,我盯着屏幕傻笑了有一分钟。值了。
重头戏:用AI训练AI,到底怎么个训练法?
原子答案:AI训练AI是让模型互相当老师和考官——一个AI生成答案,一个AI打分筛选,人只抽查把关,这套流水线把训练成本砍了一个量级。
这才是标题里"用AI训练AI"的正主。逻辑拆开看:AI生成一堆候选答案,另一个AI按标准打分,分高的留下来当训练数据,分低的扔掉。人干嘛?抽查,定标准,处理争议。我那三百条手工标注的活儿,换成这套流程,一个下午能产出几千条质量不差的候选——我抽检了两百条,能直接用的约占七成五。
这条路是行业明牌。DeepSeek公开的技术报告里就写过用模型相互评估来扩展训练数据的做法,各家大厂的路数大同小异。整个行业对"AI自产数据"的依赖度逐年走高,连数据标注这个职业本身都在被AI改造——先标注、后校验AI标注,人往后退半步,站到质检线上。
这套机制的前身其实很老:强化学习里让AI左右互搏的思路,AlphaGo自我对弈几千万局把人类棋手拍在沙滩上,就是同一根血脉。游戏AI是怎么自学成才的那篇把这条线讲得很完整。至于风险嘛,也有:AI喂AI,错误会像滚雪球一样传下去,行话叫模型坍缩。所以人的把关环节,短期内取消不了。
全流程一张表:AI怎么学习AI,按餐厅对照
原子答案:训练全流程等于开餐厅五环节——进食材、写菜谱、特训学徒、学徒互考、试营业验收,每个环节都有对应的AI术语和人的角色。
对照表收好,拿去给别人讲也行。
| 训练环节 | 餐厅比方 | 人的角色 | 我的实测体感 |
|---|---|---|---|
| 预训练 | 进海量食材 | 几乎不参与 | 数据清洗就够喝一壶 |
| 标注 | 写菜谱定口味 | 深度参与 | 标到80条开始怀疑人生 |
| 微调 | 学徒按菜系特训 | 出题人 | 消费级显卡就能玩 |
| AI训练AI | 学徒互相出题打分 | 抽查质检 | 效率翻几十倍,得盯紧 |
| 评估上线 | 试营业 | 最终验收 | 编电影名那次就是验收抓的 |
顺带说个数字佐证"AI训练AI"的规模:马斯克旗下的xAI公开介绍过Grok的训练依赖大规模合成数据流水线,xAI官网有相关技术说明,合成数据占比连年上升已是全行业趋势。想顺着这条线再往深处走的,推荐两篇:我让AI自己学习再教我的实验是这套机制的迷你版演示,自己训练AI的避坑指南则把上手路径铺好了。
常见问题
普通人了解AI怎么被训练出来,有什么实际用处?
用处很直接:知道训练数据有截止日期,你就明白它为什么不知道昨天的新闻;知道它是概率输出,你就明白它为什么一本正经编片名;知道微调的存在,你就明白为什么同一个底座能长出各种专用工具。懂三分原理,少七分迷信。
AI训练AI,会不会有一天人完全插不上手?
短期内不会。生成、打分、筛选确实都被AI接了,但"什么算好"这个标准目前还攥在人手里,AI坍缩的风险也要求人必须守在质检线上。我自己的小项目里,最关键的一次纠错就是人工抽查发现的。人往后退,但没退场。
我想亲手试一次微调,需要什么门槛?
最低配置:一张显存12G以上的显卡(或白嫖云端算力)、Python基础、一个开源底座模型、几千条干净数据。我的三周里有两周耗在数据上,真正跑训练只占一个周末。门槛不在算力在耐心。
AI怎么学习AI的这条流水线,我用三周和一个翻车项目换来了这篇白话版。要是它让你下次看到"AI训练"四个字不再发怵,就转给那个总说"AI跟玄学一样"的朋友——没那么玄,就是一家忙忙叨叨的餐厅。