AI智能深度学习原理:一条流水线讲清楚
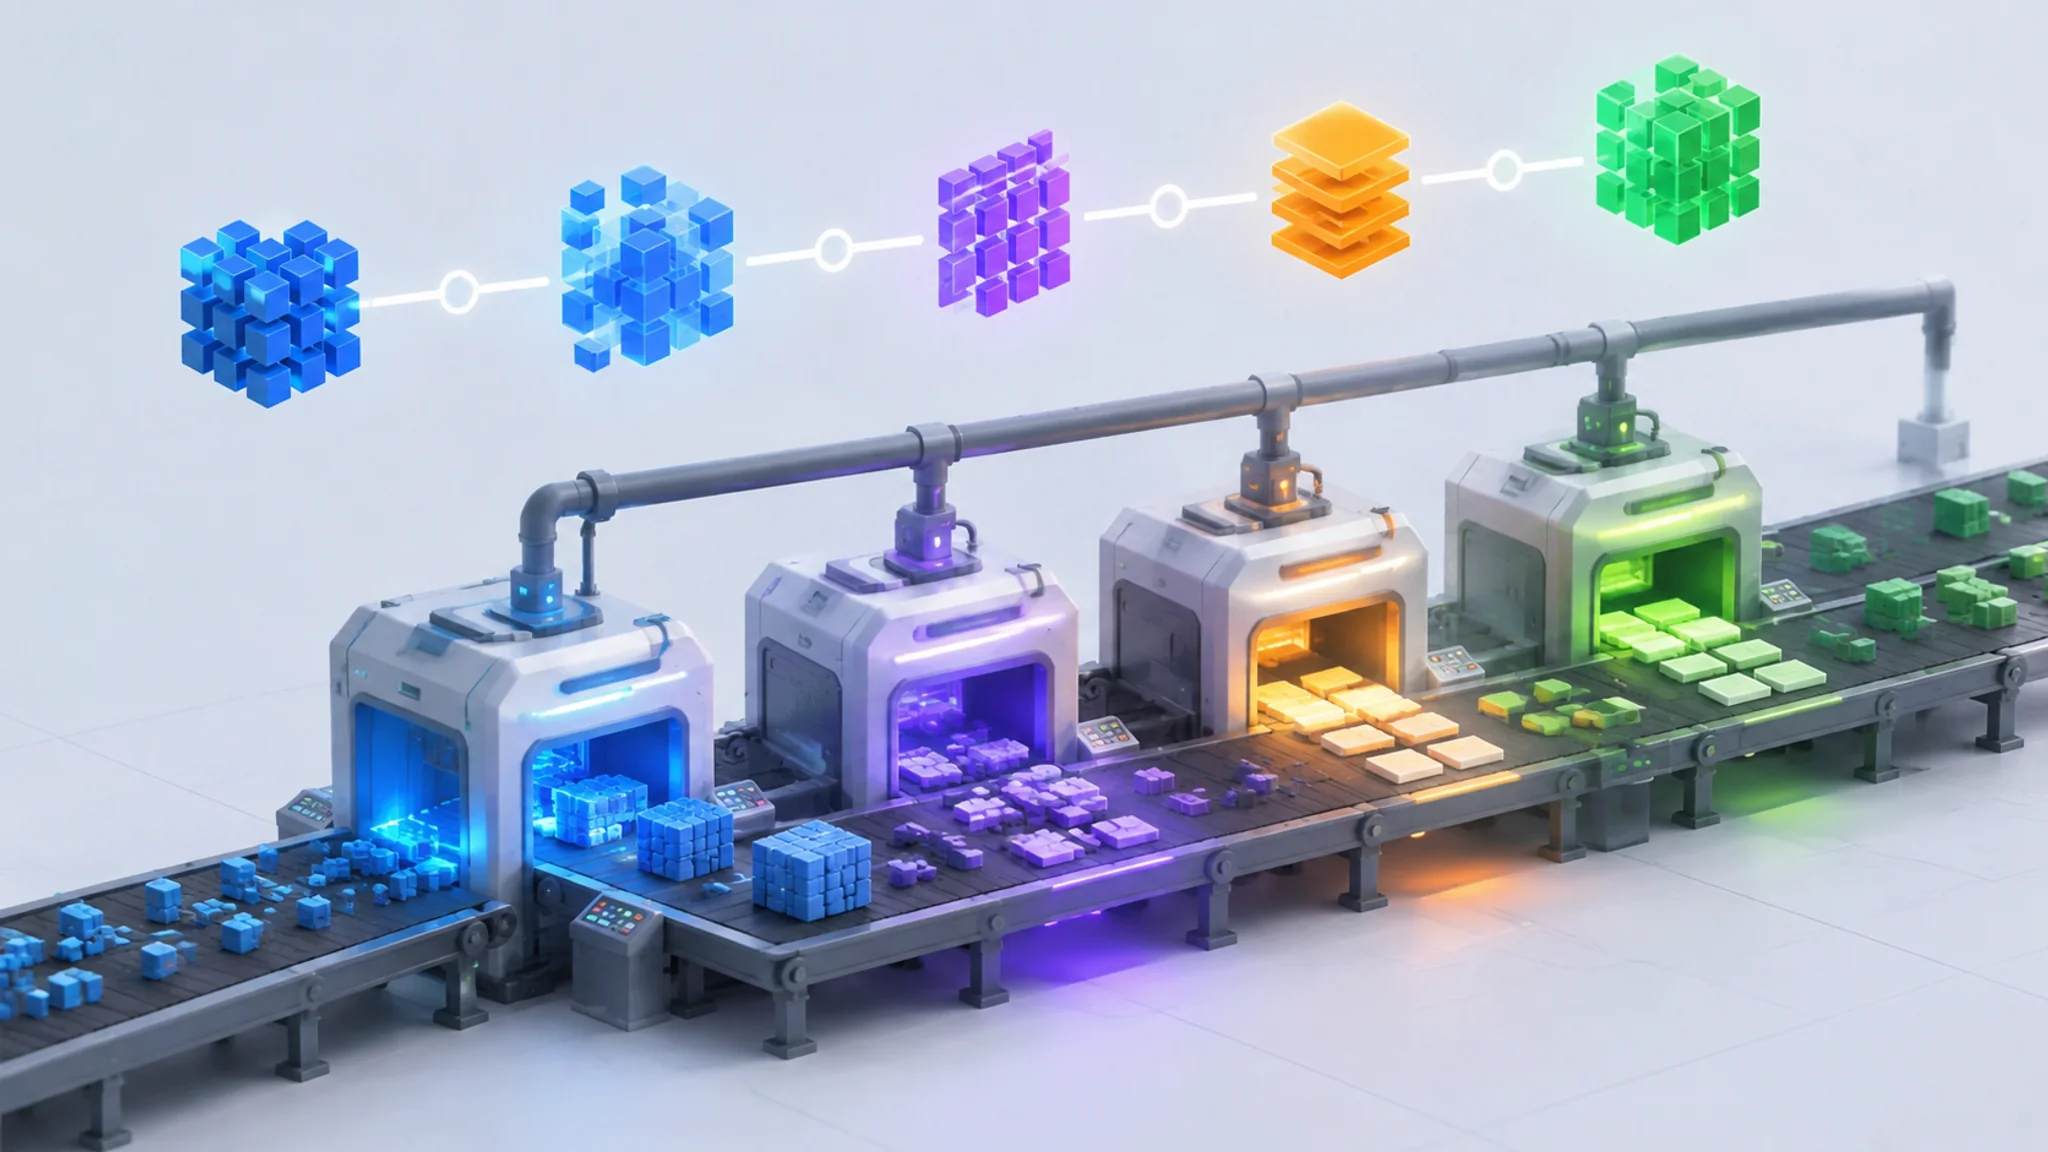

简单说:深度学习就是一条多工位的加工流水线。原料(数据)从第一站进,每经过一层网络就被加工提纯一次,浅层认边角、中层认部件、深层认整体,最后一站出货(预测结果)。"深度"指的就是工位多。理解了流水线,你就理解了AI智能深度学习原理的主干。
讲ai智能深度学习原理,教科书爱从神经元讲起,什么加权求和、激活函数,公式排山倒海。我换条路,讲个工厂。想象一家口罩厂:无纺布进厂,第一道工序裁成小片,第二道工序压出褶皱,第三道工序焊上耳绳,第四道质检贴标,最后装箱出厂。深度学习干的事结构上一模一样,只不过它的原料是图片、文字、声音,工序叫"层",产品是"判断"。为什么非得多层?因为一层干不完从"一堆像素"到"这是一只猫"的跨越,就像无纺布没法一道工序变口罩。就这么个朴素道理。
这个比喻不是我想出来的,是三年前一位做视觉的同事讲给我的,我当时豁然开朗。后来我把它画成流程图贴在工位上,又照着跑了个小模型验证,这篇把整套东西白话复述一遍。
ai智能深度学习原理的"流水线"怎么运转?
原子答案:数据进流水线后单向流动,每层做两件事——把上一层的结果加权组合,再过一道"通不通"的闸门。层层递进,简单特征逐级组合成复杂概念,末端输出各候选答案的概率。拆细每个工位。第一件事,加权组合:每个工位拿到上一站传来的所有半成品,按各自的权重搅拌混合。权重就是流水线的灵魂参数,训练说到底就是调权重。第二件事,过闸门:搅拌完的结果要过一道激活函数,可以理解成质检闸——数值不够格的直接拦下归零,够格的放行。别小看这道闸,没有它,一百层流水线等价于一层,深度就名存实亡了。数据就这么一站一站流下去,到最后一站,出口给你一份概率表:"猫92%,狗6%,沙发2%"。判断完成。
逐层看特征提取:流水线上每站都在干什么?
原子答案:浅层提取原始特征,边缘、色块、明暗;中层把特征拼成部件,眼睛、耳朵、轮廓;深层把部件组装成概念,"猫脸"。层级越高,越接近人话。这是卷积网络视觉任务里被反复验证的结构。拿"识别一只猫"走一遍流水线。第一站工人的世界没有猫,只有数字网格。它干的事特别原始:找出所有明暗交界线、颜色突变点。输出是一堆碎片线条。第二站拿这些线条拼几何形状,圆弧、三角、色斑。第三站开始有模因了:一段圆弧加两个色斑,像眼睛;三角带尖,像耳朵。第四站、第五站,部件组装成"毛茸茸的圆脸加尖耳朵"的组合。到这一步,流水线末端的分类工位一看这配置,猫,放行。神奇的地方在于:没有任何一层被单独教过"什么是猫",猫这个概念是从底层特征一层层长出来的。这就是深度学习最反直觉也最迷人的地方。
说个我验证过的小实验。我跑过一个手写数字识别的小模型,把第一层的权重可视化出来,屏幕上显示的真的是一堆明暗条纹检测器,跟教科书说的分毫不差。那一刻的感受很难形容——你亲眼看到了流水线第一站的扳手和卡尺。
插一句我手绘示意图的事。学这章时我在A4纸上画过一版流程图:最左边画个方块当数据入口,中间五列圆圈当五个工位,每列之间用箭头连,箭头上标"加权+闸门",最右边出口写"概率"。画完我发现一个之前没想通的问题:最后出口那几个答案是怎么跟前面所有工位挂钩的?顺着箭头往回捋,捋了两遍就通了,这就是反向传播的路。图我后来拍照存着,虽然画得丑,比任何教材插图都管用。说真的,手绘这事看着笨,吸收率奇高。
流水线怎么学会自己调参数?
原子答案:靠试错加回调。流水线先出一次货,跟标准答案对差距,再把误差从末端逐站传回去,每站按"责任大小"微调权重。循环几万次,流水线就调教成型了。出厂检验这段是训练的核心。第一批货出去,错得离谱:把狗认成猫。这时误差量从出口往回传,逐站问责——第五站组合"圆脸"的权重责任多大?第二站找轮廓的权重责任多大?每站拿到责任单,各自朝减小误差的方向拧一点。这就是训练一个回合。几万回合后,误差缩到够小,流水线定型,参数冻结,进入实战。逐站问责的机制有个学名,我在自动微分白话拆解那篇里用下山比喻详细讲过,两篇连读刚好凑成完整拼图。
流水线断在哪:三个常见故障的工厂版翻译
原子答案:训练不动了,通常是三种病——原料馊了(数据差)、某站堵死(梯度消失)、某站爆仓(梯度爆炸)。翻译成工厂话,故障定位会容易得多。第一种,原料问题。垃圾进垃圾出,标注错乱的图片喂再多,流水线学出来的也是错的。我踩过:数据集里有百分之十几的图标错类,模型 accuracy 死活卡在80%上不去,清理后直接破95%。数据质量这课,值那三天排查。第二种,堵死。误差往回传的路上逐站衰减,传到前几站时已经约等于零,浅层工位收不到责任单,永远学不到东西。经典解法是换激活函数、加残差连接。第三种,爆仓。反过来误差越传越大,数值溢出,出口直接吐NaN,全线停摆。这三种病占新手训练故障的大头,会翻译成"堵死"和"爆仓",你搜解决方案都快很多。想系统补故障排查,零基础啃三个月的进度记录里有实战版。
这条流水线跟深度学习的关系,一层窗户纸
原子答案:深度学习等于"很多层的流水线",AI是所有这类技术的总称。层不是越多越好,够用就好——层数翻倍,算力翻几倍,效果未必涨。最后把三个词的关系钉死:AI是大目标,机器学习是实现路线,深度学习是机器学习里"用多层流水线"的那一派。现在火的大语言模型,流水线工位换成了注意力结构,加工对象从像素换成了词,骨架还是层层提纯那一套。所以把流水线模型吃透,等于同时握住了理解大模型的钥匙。据斯坦福AI Index报告的追踪,模型训练算力需求这些年以数量级速度攀升,背后正是流水线越架越长的现实。层次关系的完整版,我推荐配着AI智能和深度学习的关系图一起看。刚入门想跑代码的,从第一个能跑的小项目下手,TensorFlow Playground这个网页小工具也能拖一拖就看到流水线逐层变化,值得玩十分钟。
常见问题
深度学习和机器学习是一回事吗?
不是。机器学习是大类,深度学习是其中用多层神经网络的一个分支。可以理解成流水线工业和某条具体产线的关系。
层的数量是不是越多越聪明?
不是。层数过深会带来梯度消失和算力浪费,效果甚至倒退。学术界为加深网络发明了很多补救结构,够用的深度才是好深度。
不看数学能把深度学习原理搞懂吗?
搞懂直觉可以,看懂论文不行。流水线比喻能支撑你用框架、调模型、排故障,要读前沿论文还是得回去补线性代数和概率。
为什么说深度学习需要大量数据?
流水线每个工位的权重都要靠数据喂出来,工位越多待调的权重越多。数据不够,权重调不准,流水线学出来的就是死记硬背。
那张手绘图还贴在我工位上,每次忘了哪层干什么就瞄一眼。要是这条流水线也帮你把原理捋顺了,转给一起学AI的朋友,这玩意儿比段子值得转发。