机器学习到底是什么?不写公式也能讲明白
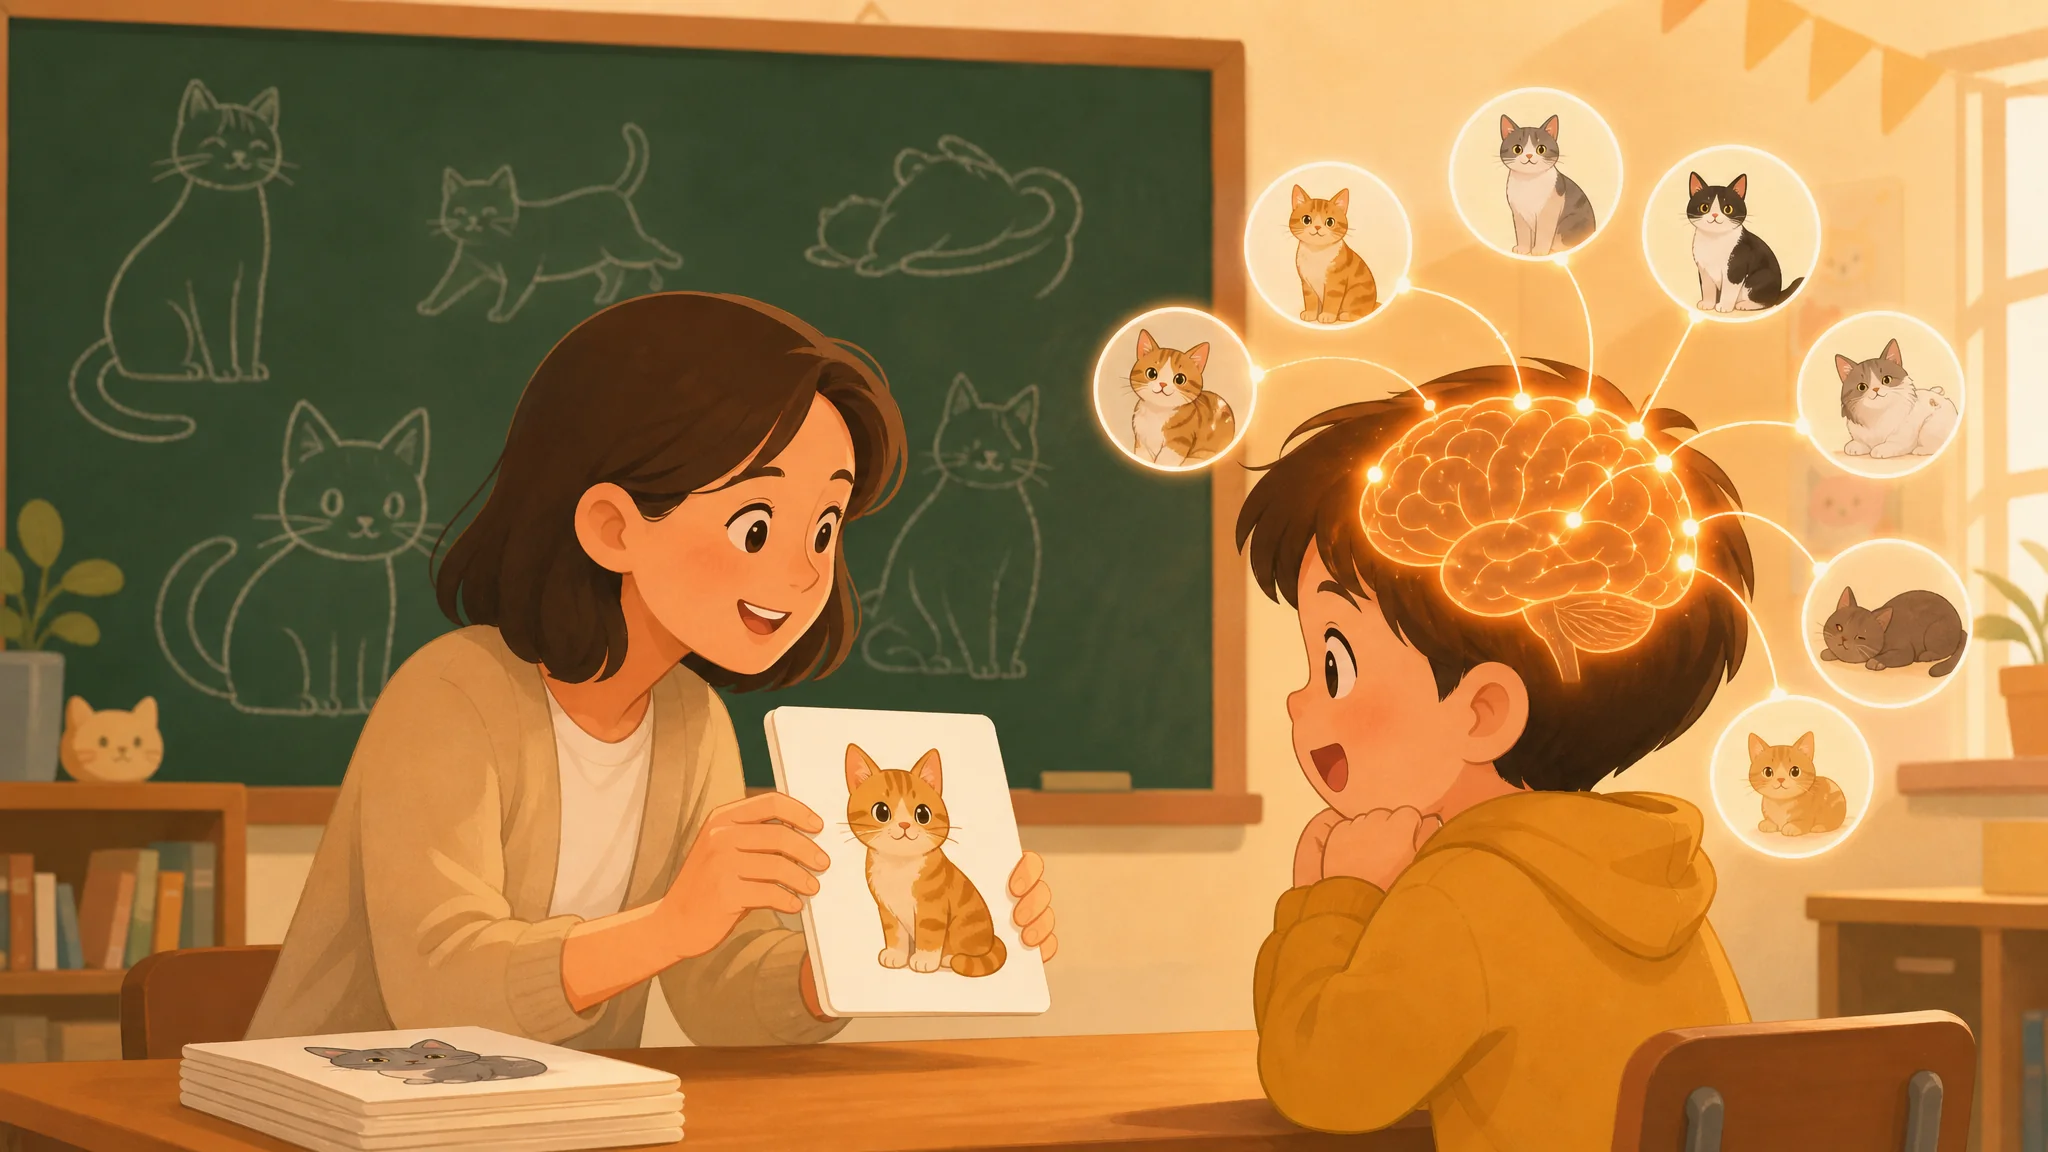

简单说:机器学习就是让计算机从一堆例子里自己找规律,而不是让人把规则一条条写给它。你给它看一万张猫照片,它自己总结出"猫长什么样"。不需要数学基础也能理解它的全部核心思想。
机器学习 ai这个词组,十个人有九个觉得高深。可我姥姥听完我讲之后说了句"这不就是熟能生巧嘛",你还真没法反驳她。这篇我不写一个公式,就拿"教三岁小孩认猫"这一件事,把机器学习的全流程走完。中途会插一段我自己动手做猫狗识别实验的翻车记录——放心,翻的不是我的车,是机器的车。
机器学习的第一课:AI不是被编程出来的,是被喂出来的
原子答案:传统编程是人写规则、计算机执行;机器学习反过来,人给例子,计算机自己产出规则。核心区别就这一句话,剩下的全是细节。想象你教三岁的外甥认猫。你绝不会跟他说"猫是一种具有可伸缩爪部、竖瞳孔的猫科动物"。你干嘛?你指着小区里的橘猫说"这是猫",指着邻居家柯基说"这不是猫"。指得多了,孩子自己会总结:尖耳朵、胡须、四条腿、走路没声的那个毛茸茸的是猫。机器学习干的就是这个。你把一万张标好"猫"或"不是猫"的照片喂给程序,它自己调整内部的一大堆旋钮(参数),直到判断越来越准。这一步行话叫"训练"。通俗版本我之前在能自己学习的机器长啥样里也聊过,今天这篇往下多挖两层。
训练机器学习 ai模型第二步:猜、错、改,循环一万次
原子答案:训练的本质是循环三步——模型猜答案、对照标准答案算错多少、根据错误调整参数。重复几万次,它就从瞎猜变成靠谱。跟孩子练字一个道理:写、被圈出来、擦了重写。具体拆开讲。第一轮,程序内部的旋钮全是随机值,你给它看猫照片,它猜"是狗"。错得离谱。这时候有一个东西负责打分——行话叫损失函数,你就理解成"错了多少分"。分数出来后,另一个机制负责把每个旋钮往"能让错误变小"的方向拧一点,这个过程有个响亮的名字叫反向传播,本质就是"知错就改,每次改一点点"。看一张照片、拧一圈旋钮,重复十万次。最后那组拧好的旋钮,就是所谓的"模型"。你手机相册里能按"猫"搜照片,背后就是这么个拧好了的模型在干活。想更系统地了解AI和机器学习的层次关系,可以看我画的那张套娃结构图,一句话版:机器学习是实现AI的一条路,深度学习又是机器学习里的一支。
过拟合:机器学习最经典的翻车,我亲手复现过
原子答案:过拟合是模型把训练例子的细节当成了通用规律——就像孩子只见过你家的橘猫,就认为黑猫不算猫。我亲手做的猫狗识别实验里,训练准确率98%的模型,换一批新图直接掉到71%,这就是过拟合的现场。说我的翻车记录。前年我照着网上教程做了个猫狗分类器,训练完一看报告,准确率98%,飘了。兴冲冲丢给我家橘猫新拍的照片——识别成狗。不信邪,又测了两百张没参与训练的新图,整体准确率只有71%。差在哪?我训练用的图库是室内宠物照,测试图一半是户外抓拍。模型学到的不是"什么是猫",而是"室内光线下毛茸茸的东西是猫"。这就是把参考答案的墨迹都背下来的学生,换个考场就露馅。怎么治?方法不少,最直白的一个:给它看更多、更杂的例子。我把训练图扩到四千张、掺进户外照之后,新图准确率回升到89%。这事给我的触动比看十篇教程都深——机器学习的上限不在算法多聪明,在你喂它的例子够不够全面。这个概念在工业界坑过无数项目,想看更细的分类概念可以读维基百科的机器学习词条,中文版写得相当可读。
话说回来,你可能听过监督学习、无监督学习这些黑话,听着吓人,其实用认猫这一件事就能全讲通。监督学习,就是每张照片都贴了标签(这是猫/这不是猫),有标准答案的学习;无监督学习,就是一堆照片不贴标签,让程序自己按长得像不像分堆,它可能分出"毛茸茸的""有羽毛的""发光的"几堆,分完你来命名。强化学习另算一路,不认猫了,改学骑自行车——摔倒扣分、骑稳加分,摔多了就会了。AlphaGo下棋、游戏AI打游戏,走的都是这条路子,我在游戏AI强化学习入门里有展开。三兄弟记住这个比喻就够了,别背概念。
| 黑话 | 认猫版翻译 | 生活里的例子 |
|---|---|---|
| 训练 | 指着照片反复教 | 给孩子刷口算卡 |
| 参数 | 孩子脑子里"猫长啥样"的印象 | 手感、语感这种说不清的东西 |
| 损失函数 | 答错扣几分 | 老师批改的红叉 |
| 过拟合 | 只认你家的橘猫 | 只会做原题,换数字就错 |
| 泛化 | 没见过的猫也认得 | 举一反三 |
| 数据集 | 那一摞照片 | 五三、黄冈、真题卷 |
机器学习跟AI是什么关系?为什么老连在一起写
原子答案:AI是大目标"让机器像人一样聪明",机器学习是实现这个目标的主流手段"从例子中学规律"。所以机器学习 ai常被连写——一个是目的地,一个是现在最堵的那条路。上世纪五六十年代的AI走的是另一条路:专家规则系统,让人类专家把知识一条条写成"如果发烧且咳嗽则可能是感冒"的规则。规则写到几十万条就崩了——世界太杂,写不完。转折发生在数据变多、算力变便宜之后:与其教机器规则,不如喂它例子让它自己学。今天的AI热潮几乎全是这条路撑起来的,聊天、翻译、识图、下棋,底层都是机器学习在跑。这三次浪潮的兴衰史我复盘过一篇机器学习三起两落,读起来像一部肥皂剧。你要是问机器学习这波到底是不是泡沫——我的看法是技术是真的,吹的项目里有泡沫,两者不冲突。
常见问题
机器学习必须学数学吗?
理解思想不需要,动手做项目需要一点,做研究才需要啃透。我认识的不少应用层工程师,数学是边做边补的。正确的入门路径看零基础学AI的顺序那篇,先动手再补理论,弯路最少。
机器学习和深度学习是一回事吗?
不是。深度学习是机器学习里的一个分支,用的模型层数更深,就是新闻里常说的神经网络。关系像水果和苹果:深度学习是机器学习的一种,机器学习是实现AI的一种。
普通人了解机器学习有什么用?
能识破宣传里的水分。看到"AI精准""智能学习"这类词,你知道背后可能只是个统计模型,效果取决于喂了什么数据,就不会为玄学买单。我拿教育产品验过这个判断,写在了AI精准学习是营销词吗。
想亲手跑一次机器学习,最低配置是什么?
一台普通笔记本就够,入门数据集用公开的,工具免费。第一次跑通猫狗识别那种小实验,四核CPU半小时内能出结果,我的配置单放在跑机器学习的电脑配置里了。公开的入门数据集在Kaggle上能白嫖一堆,从零成本开始完全没问题。
机器学习的全部秘密,其实就是姥姥那句话:见得多了,就会了。下次再有人拿AI三个字母唬你,你就问一句"它吃的什么数据",一问一个准。觉得这篇白话版讲明白了,转给那个总觉得机器学习高深莫测的朋友吧,也许他就差你这一个转发。