机器学习AI是什么意思?一个比喻就能讲通
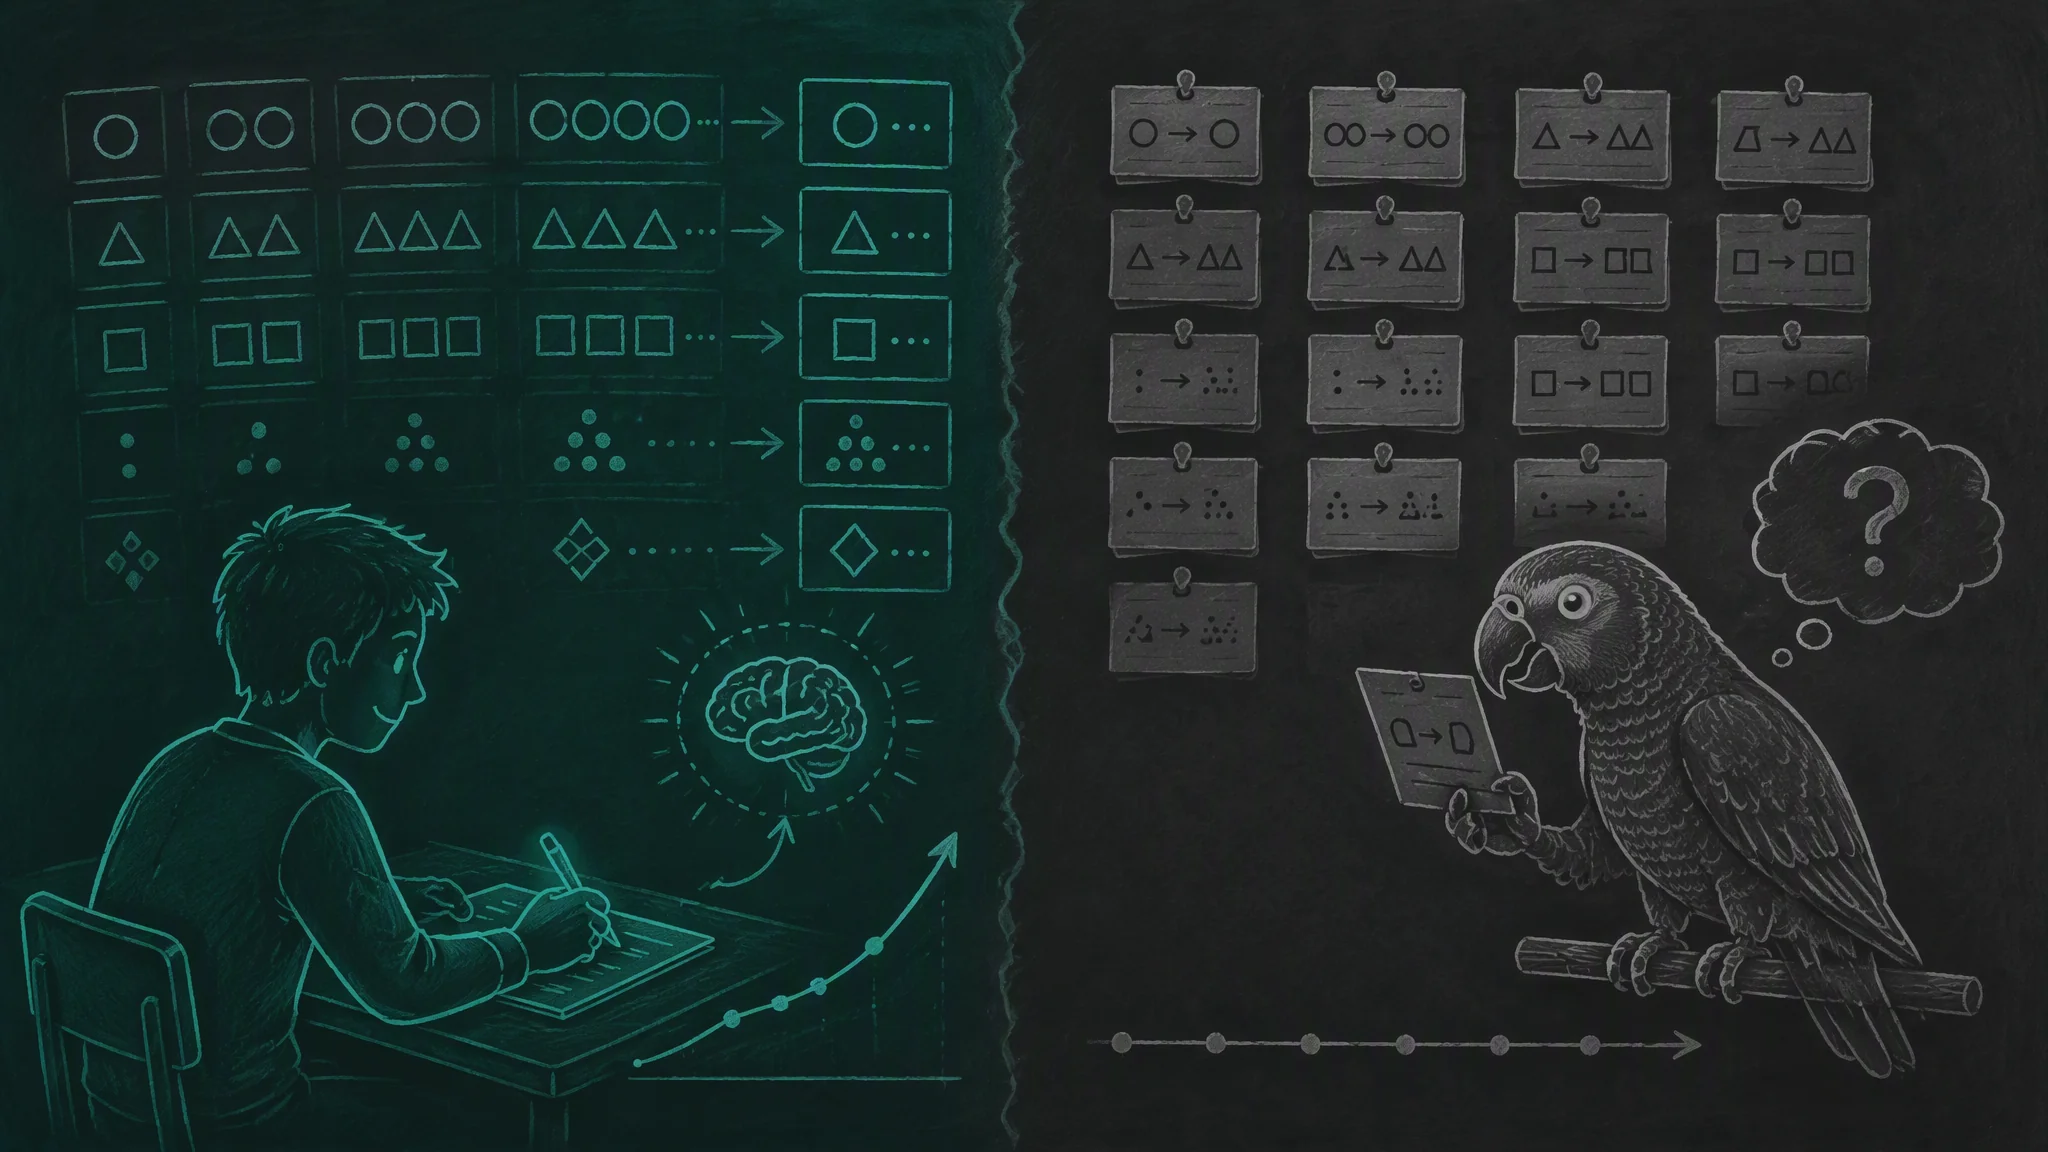

简单说:机器学习AI就是让计算机从大量例题里自己总结解题套路,而不是由人把规则写死。你给它一万道带答案的题,它练出一个“手感”,下次遇到新题就靠这个手感猜。就这么回事。
先问一句:机器学习AI什么意思,你得到过能听懂的答案吗?这问题我被问过不下十次。问的人有我丈母娘、公司实习生、还有出租车司机。每次我从“算法”讲到“模型”,讲到对面眼神涣散才罢休。后来我换了个讲法,从刷题说起,五分钟讲通,丈母娘听完还追问了一句“那它会不会考砸”。这篇就把这套讲法完整写出来,外加我当年入门时记的理解笔记,给同样被概念绕晕的人。
先把关系摆正:机器学习是实现AI的一条主要路线,俩词不是一回事,但日常语境里经常混着用。这个关系我之前画过一张层次图,在AI和机器学习的套娃结构那篇里,这里不展开,专注回答“什么意思”。
刷题的比喻:一段话讲透机器学习AI什么意思
原子答案:机器学习就像让一个学生海量刷题——它不背规则,而是从一万道例题的“题干加答案”里,自己摸出规律。摸出来的规律就叫“模型”,刷题过程叫“训练”,拿新题检验就叫“预测”。
展开讲这个比喻。想象一个只见过数学课本目录、但从没读过概念定义的学生,直接开始刷题。第一题,2+3=5,对。第二题,4+1=5,对。刷到第五十题,他隐约觉得两个数摆一起中间加个符号,答案跟它们的大小有关。刷到第五百题,“手感”成形:见题就能给个八九不离十的答案。
没人给他讲过加法的定义。这就是机器学习和传统编程的根本区别:传统编程是人写规则,机器执行——你把加法口诀一行行写进代码;机器学习是人给例题,机器自己归纳——你丢给它一万道加法题和答案,它自己长出加法能力。
三步对应三个术语,记住这个映射,看科普文就不迷路了:例题册叫“训练数据”,练出的手感叫“模型”,用新题考它叫“预测”。丈母娘问的“会不会考砸”,会,而且有个专门名词叫“泛化失败”——平时刷的题全对,一到新题型就翻车。
我当年的理解笔记:三个让我开窍的瞬间
原子答案:让我开窍的不是教材,是三次把抽象概念挂到生活经验上的瞬间:垃圾邮件过滤、音乐App推歌、输入法联想。这三个场景各对应机器学习的一个核心概念。
2021年我开始补机器学习的课,教材啃得很痛苦,公式认识了,意思没进去。真正打通是靠三个日常场景,我把笔记原文的思路复述给你。
第一个瞬间:垃圾邮件。为什么邮箱能自动把“发票代开”扔进垃圾箱?没有人给程序员写规则说“含发票俩字的算垃圾邮件”——那正常报销邮件也得躺枪。真实做法是拿几百万封人工标记过的邮件(好/坏)给它刷,它自己学会分辨。第一次想通这点,我盯着邮箱发呆了半分钟。原来“规则是人写的”这个直觉,在这里不成立。
第二个瞬间:音乐App的每日推荐。为什么它推的歌越来越对你的胃口?因为你的每次播放、跳过、收藏都是一道“例题”,模型天天拿你的行为加练。这是我理解“训练”和“数据”的第二课:数据不是一次性倒进去的,是持续喂的。这条笔记后来直接影响我的学习方法——想要AI产出好,先喂它足够多的偏好样例,这个习惯我写进了AI对话学习法的提问框架里。
第三个瞬间:输入法联想。为什么打“周一”它联想“例会”?因为它见过海量聊天记录里这俩词总挨着。这是“统计规律”的具象化——机器不懂语义,它只是算概率。想通这个,你对AI的期待就会校准:它是概率玩家,不是知识持有者。它一本正经胡说八道(行话叫幻觉)的毛病,根源也在这,下一个 section 细说。
三个常见误区:讲懂机器学习AI是什么意思之后
原子答案:误区一是以为AI真的“理解”内容,它只是在算概率;误区二是以为数据越多效果一定越好,题册脏了练出来的手感也是脏的;误区三是以为AI不会出错,恰恰相反,它是概率机器,天然带错误率。
误区一,AI有理解。没有。至少当下的主流机器学习没有。“猫”这个字对模型来说是一串数字向量,它从没见过猫,只是见多了“猫”和“喵”“毛茸茸”共现的文本。有人觉得这是抬杠,但这个认知直接影响你用它干活的方式:它写的东西必须人工核,因为它不懂,它只是很会“接着写”。我团队的红线就是AI产出未经核对不许对外发。
误区二,数据大就是好。错。训练数据要是刷题册里一半答案是错的,学生练出的手感就是歪的。行业里管这叫“垃圾进垃圾出”。这个概念对你挑选AI产品也有用:某某AI在某专业领域很拉胯,多半不是它笨,是它没刷过那个领域的题。
误区三,AI很稳定。恰恰相反。同一个问题问三遍,答案可能三个版本,因为它的生成机制本质是掷一个被调过概率的骰子。把它当个聪明但话痨的实习生用,你就不会踩坑。这些误区在我的入门踩坑清单里都有展开,想避雷的看AI入门的五大误区,全是学费换来的。
深入一点:三种刷题姿势对应三类学习
原子答案:刷带标准答案的题叫监督学习,最常用;自己瞎琢磨找规律叫无监督学习;靠奖惩反馈练出来的叫强化学习,AlphaGo下棋就是这条路。日常你听到的AI应用,九成是监督学习。
这几个名词在科普文里出现率极高,还是用刷题串起来。监督学习:题册带答案,学生对着练,练完对答案调整。垃圾邮件过滤、图片分类、房价预测,全是这类。你手机相册能自动认出“猫”的照片,靠的就是几百万张人工标注“这是猫”的图片喂出来的监督学习模型。
无监督学习:题册没答案,学生自己把题分类——这些题长得像,堆一堆。电商的用户分群就用这招,没人告诉模型“这类人叫价格敏感型”,是它自己把相似行为聚成堆,人再给堆贴标签。
强化学习:不给题册,给一个奖惩机制。下对一步加分,下错扣分,学生自己反复试错练出套路。游戏AI、机器人控制、大模型训练里的对齐环节都有它。想更形象地理解这条路线,可以看游戏AI是怎么自学成才的,从下棋到打星际全是强化学习的秀场。
三类的地位悬殊很大:监督学习是绝对主力,产业界九成的活它干;无监督偏辅助;强化学习名气最大(因为AlphaGo一战封神),日常出场率反而低。知道这个比例,你就不会被“强化学习改变一切”的标题带节奏。
为什么这个概念值得普通人花十分钟搞懂
原子答案:懂了机器学习的底层是“从数据里归纳统计规律”,你在三件事上会立刻受益:评估AI工具的真实能力、识别AI营销话术的水分、以及把自己的本职经验变成喂AI的高质量数据。
第一件事,选工具不再被忽悠。厂商说“AI驱动决策”——翻译一下:它从历史数据里归纳了些规律。那你该问:数据是哪来的?覆盖我这个行业吗?质量如何?三问下去,九成的营销话术当场现形。
第二件事,看新闻有抗体。“某AI诊断准确率超过医生”这种标题,懂行的人会去看细节:在哪个数据集上测的?什么病种?测试集和训练集有没有重叠?这些追问的能力,就来自对“刷题”机制的理解。行业新闻的真假判断标准,我在AI和机器学习安全话题那篇里也给过一套,配合食用。
第三件事最实际:把经验变成数据。既然模型靠例题练手,那你在用AI时给它的好例子越多,它替你干的活越像你。我现在写周报,先丢三篇我过往的周报给AI当例题,出来的初稿能直接用七成。这个“喂例题”的动作,本质上就是你在给模型做一次微型训练。想深挖概念底层,权威的定义可以读维基百科的机器学习词条,Coursera上吴恩达的入门课(coursera.org可搜到)则是公认最好的系统入门。
话说回来,一个概念让外行听懂的最大障碍,从来不是概念本身难,是讲的人不肯说人话。这篇要是还没讲通,责任在我,评论区接着问。
常见问题
机器学习和人工智能是一个东西吗?
不是。人工智能是大目标——让机器表现出智能,机器学习是实现这个目标的主流手段——让机器从数据里自己学规律。打个比方:人工智能是“考上好大学”,机器学习是其中最有效的“刷题路线”。当下你听到的AI应用,绝大多数底层是机器学习。
机器学习AI是什么意思,跟深度学习又是什么关系?
深度学习是机器学习的一个分支,用的是多层神经网络这套“题册结构”。可以理解为刷题方法里的一种特殊姿势:层层递进地提取特征,先认笔画再认偏旁再认字。近年大模型的爆发主要靠它。三者是套娃关系:人工智能包含机器学习,机器学习包含深度学习。
为什么AI会一本正经地胡说八道?
因为它本质是概率机器,不是知识库。它在“算下一个词最可能是什么”,而不是“查证这个事实是否为真”。训练数据里的错误、语境的误导都会让它流畅地输出错误内容。对策只有一个:重要信息人工核对,把AI当聪明但不可全信的实习生。
零基础想系统了解机器学习,从哪开始?
分两条路。只想理解概念看科普:维基百科词条加几篇白话文(比如我写的监督学习白话版)就能建立框架。想动手学:从Python基础到跑通第一个模型,路线和坑我在这行的入门顺序文里都记了,业余时间三个月能摸到门槛。
一个比喻讲透一个概念,这买卖划算。机器学习AI是什么意思这个问题,希望你看完能给别人讲个大概——讲得出,才算真懂。觉得讲得明白就转给还在被术语劝退的朋友,也可以推荐给家里那个总问“AI到底是个啥”的长辈。有没讲透的地方,评论区砸过来,我补课。