AI学AI工具推荐:我淘汰赛后的最终名单
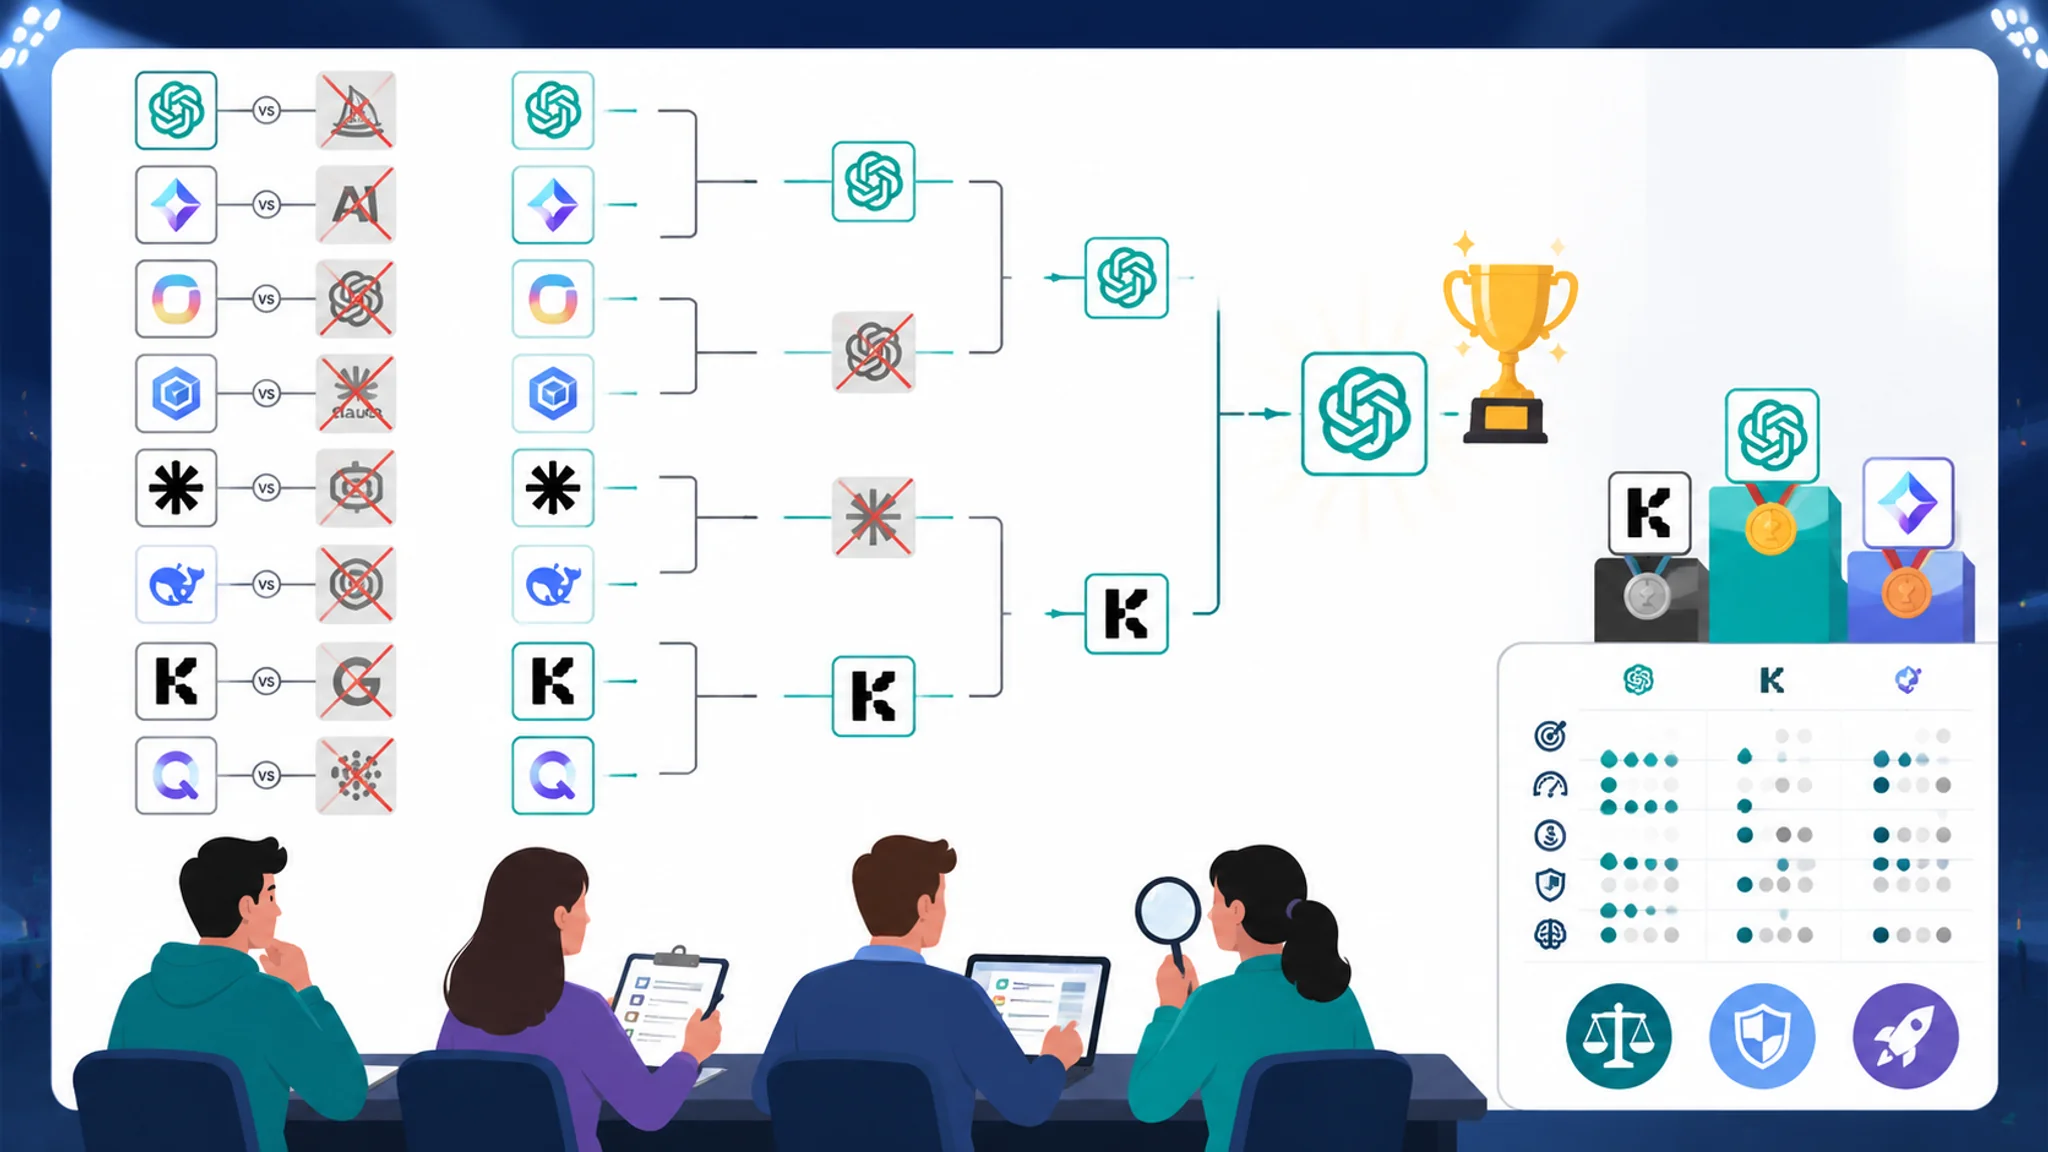

简单说:AI学习AI推荐这件事,我的答案是一场淘汰赛跑出来的——十六个候选杀到只剩三个。主讲工具给豆包,练习陪练用一个出题类应用,查漏补缺交给一个长文档工具。名单之外的全卸了,学AI反而顺了。
起因很简单:收藏夹里关于ai学习ai推荐的帖子存了二十多条,AI工具装了十几个,结果呢?学AI这件事本身被"研究用哪个工具"给挤没了。有天晚上我意识到,自己已经连续三天在折腾各种App的设置,一页正经内容没看。
不夸张地说,这是新手最隐蔽的坑。
一气之下我把所有候选拉出来,办了场淘汰赛。规则自己定的:同一道题发给所有选手,看谁讲得明白、谁出的题靠谱、谁的免费额度扛造。全程记录在案,下面就是赛况。
淘汰赛怎么打的:ai学习ai推荐工具的评判标准
原子答案:三个硬指标——讲同一个概念谁先让我听懂、追问三轮谁不烦不糊弄、免费额度谁够学一个月。三个维度各占一票,两两对撞,输的当场卸载。
参赛选手十六个,粗分四类:通用对话类(豆包、Kimi、文心一言、通义、ChatGPT、Gemini)、出题练习类三个、笔记整理类四个、还有三个垂直类的所谓"AI学习平台"。
测试题目我也固定了三道:用自己的话解释"机器学习到底在学什么";给一道我答错的题,看它怎么讲;让它针对我的薄弱点连出五道递进的题。这三道题分别考讲解力、纠错力和陪练力。
为什么这么设计?因为我学AI最大的痛点不是找不到资料,是资料看得懂却不会用,错在哪没人指出来。工具能不能当陪练,比它能不能当百科全书重要得多。这个认知我在 用AI工具学AI 那篇里踩过坑:工具挑多了反而学不会。
小组赛第一场:豆包对文心,讲解力对决
原子答案:豆包赢在"讲人话",同一个概念它的例子更贴生活,追问到第三层还接得住。文心的回答更书面化,第一遍读着费劲,但知识密度其实不低。
这道题是解释机器学习。两个的回答我都截了图对比。豆包用了个教小孩认猫的例子——给它看一万张猫的照片,它自己总结规律,下次见到新的猫也能认出来。一句话我懂了。
文心的回答结构工整,先给定义再分三类展开,术语密度高。第一遍读,卡在"假设空间"这个词上。追问"假设空间是啥",它解释了,但新解释里又冒出两个新术语。像套娃。挺磨人的。
不过公平起见要说明:文心在专业问题上深度更好,后面有道梯度下降的题它讲得比豆包细。所以这场判豆包胜,是按"新手第一遍能不能听懂"这个标准。你要已经过了入门期,结论可能反过来。
小组赛第二场:ChatGPT对Gemini,陪练力对决
原子答案:ChatGPT的出题梯度设计更用心,会从易到难铺垫;Gemini胜在响应快、多模态顺手,能把我手写的推导拍照识别出来批改。综合下来这轮Gemini小分胜出。
这轮的戏肉在"连出五道递进的题"。我故意第一题就答错,看它们怎么反应。ChatGPT发现我错之后没直接给答案,反问了一个引导性问题,这个处理很老师范。但连问它几轮"为什么",回复开始变得冗长,车轱辘话多。
Gemini那边的意外惊喜是拍照批改。我把手写的反向传播推导拍给它,它圈出了我抄错的一个下标。就这一个纠错,值回整场比赛。具体体验我写过一篇 用谷歌AI学AI:Gemini当老师是什么体验,细节都在里面。
两个都有资格晋级。但免费额度上ChatGPT很快撞墙,一天几十条消息的限制对高频追问的人不够用。Gemini的额度当时宽裕些。这也是真实取舍,白嫖党都懂。
中间几轮我快速带过。笔记类全军覆没,理由很粗暴:AI整理的笔记我自己不写的部分根本记不住,全靠AI记等于没记。出题练习类活下来一个,它的题库质量一般,但有个"错题追杀"功能——你错过的知识点,它隔几天换着花样再考你,直到你连对三次。这个设计留住了它。
三个垂直学习平台全部出局。慢,贵,界面花哨,核心的问答能力还不如通用工具。挺讽刺的。
最可惜的是Kimi。长文档能力真强,喂一本三百页的教材进去能精准定位内容,半决赛输在出题太保守,翻来覆去考定义。但如果你学的是啃大部头资料的路线,它该进你的名单。要说明这是我个人体感,各家的模型迭代很快,你现在去测结果可能不同,模型能力评测可以参考 维基百科的大语言模型词条 里跟踪的主流进展。
最终名单:三个席位,各司其职
原子答案:主讲给豆包——日常概念理解、追问展开都靠它;陪练留给那个出题App,专治"以为会了";查漏给一个长上下文工具,啃论文和官方文档时上。三个够了,多一个都是负担。
用法分工我定得很死:新概念先问主讲,听懂后立刻去陪练那边做题验证,做错了带着错题回主讲那边追问。周末啃长材料时才动用第三个。这个闭环跑了一个月,是我学AI以来完课率最高的一个月——四门收藏的课干完了三门。
名单得给个表:
| 席位 | 工具类型 | 核心用途 | 免费够用吗 | 我的主观分 |
|---|---|---|---|---|
| 主讲 | 豆包 | 概念讲解、多轮追问 | 够 | 9分,例子给得聪明 |
| 陪练 | 出题练习App | 验证是否真会、错题追杀 | 勉强,广告多 | 7.5分,功能糙但管用 |
| 查漏 | 长上下文工具 | 啃论文、定位教材内容 | 够 | 8分,慢工出细活 |
落选名单里我个人最意难平的是Kimi,前面说了,长文档是真强。决定名单前我也参考过各家官方的能力说明,OpenAI 官网 openai.com 上的模型文档比传闻靠谱,建议选工具前都去源头看一眼。
淘汰赛打完,我悟了三件事
原子答案:第一,工具数量和学习效果负相关,一个环节留一个就行;第二,免费版足以支撑入门全流程,别急着付费;第三,工具的"回答风格"比"知识量"更影响学习体验。
第一件事前面反复说了。第二件事展开讲讲:十六个候选里付费的我一个没充,最终名单三个全是免费或免费够用的。入门阶段你根本用不到付费版的深度能力,这话我敢打包票。真到要付费的节点,说明你已经知道自己缺什么了,那时候再花这个钱不迟。工具价格怎么掰扯,AI学习工具价格一览 写得更细。
第三件事最反直觉。同样一个知识点,A工具讲得像论文,B工具讲得像朋友,你的理解速度能差一倍。所以别迷信"最强模型",适合你脑子的才是好的。这就得自己动手测,别人的推荐——包括我这篇——都只能当起点。
话说回来,淘汰赛本身也是学习。为了评判工具讲得对不对,我被迫查了不少资料交叉验证,这个过程学到的东西不比正课少。
常见问题
为什么不直接推荐具体产品名,而是按席位分类?
因为AI工具迭代太快,我今天点的名下个月可能就翻篇。但"一个主讲加一个陪练加一个查漏"的结构是稳的,工具可以换,席位留着。照结构去配,比抄名单耐用。
零基础学AI,装你名单里这三个就够了吗?
够,而且我建议刻意只装这三个。新手最大的敌人是折腾工具的热情超过学习本身。三个以内,腾出的精力全砸在概念理解和做题验证上,进度反而快。
淘汰赛的标准里为什么不看参数和跑分?
跑分是厂商的事,听懂是自己的事。我唯一在乎的是"它能不能让我学会",这个指标跑分榜单测不出来。真想看数据,各家官方文档比第三方榜单靠谱。
陪练出题的App会不会练了个寂寞,题目和真实考点脱节?
有这个风险,所以我的用法是题目只当"检测器"不当"教材"——它考不过说明我概念有洞,回头找主讲工具补。用AI学AI,出题和讲解分工给不同工具,互相补盲区。
这份ai学习ai推荐的名单是我一场场打出来的,你拿去当起点,记得自己也动手测一轮。觉得有用就转给那个收藏夹比你还满的朋友,救人一命。