AI算法学习从哪个算法开始?新手别贪多先啃透三个
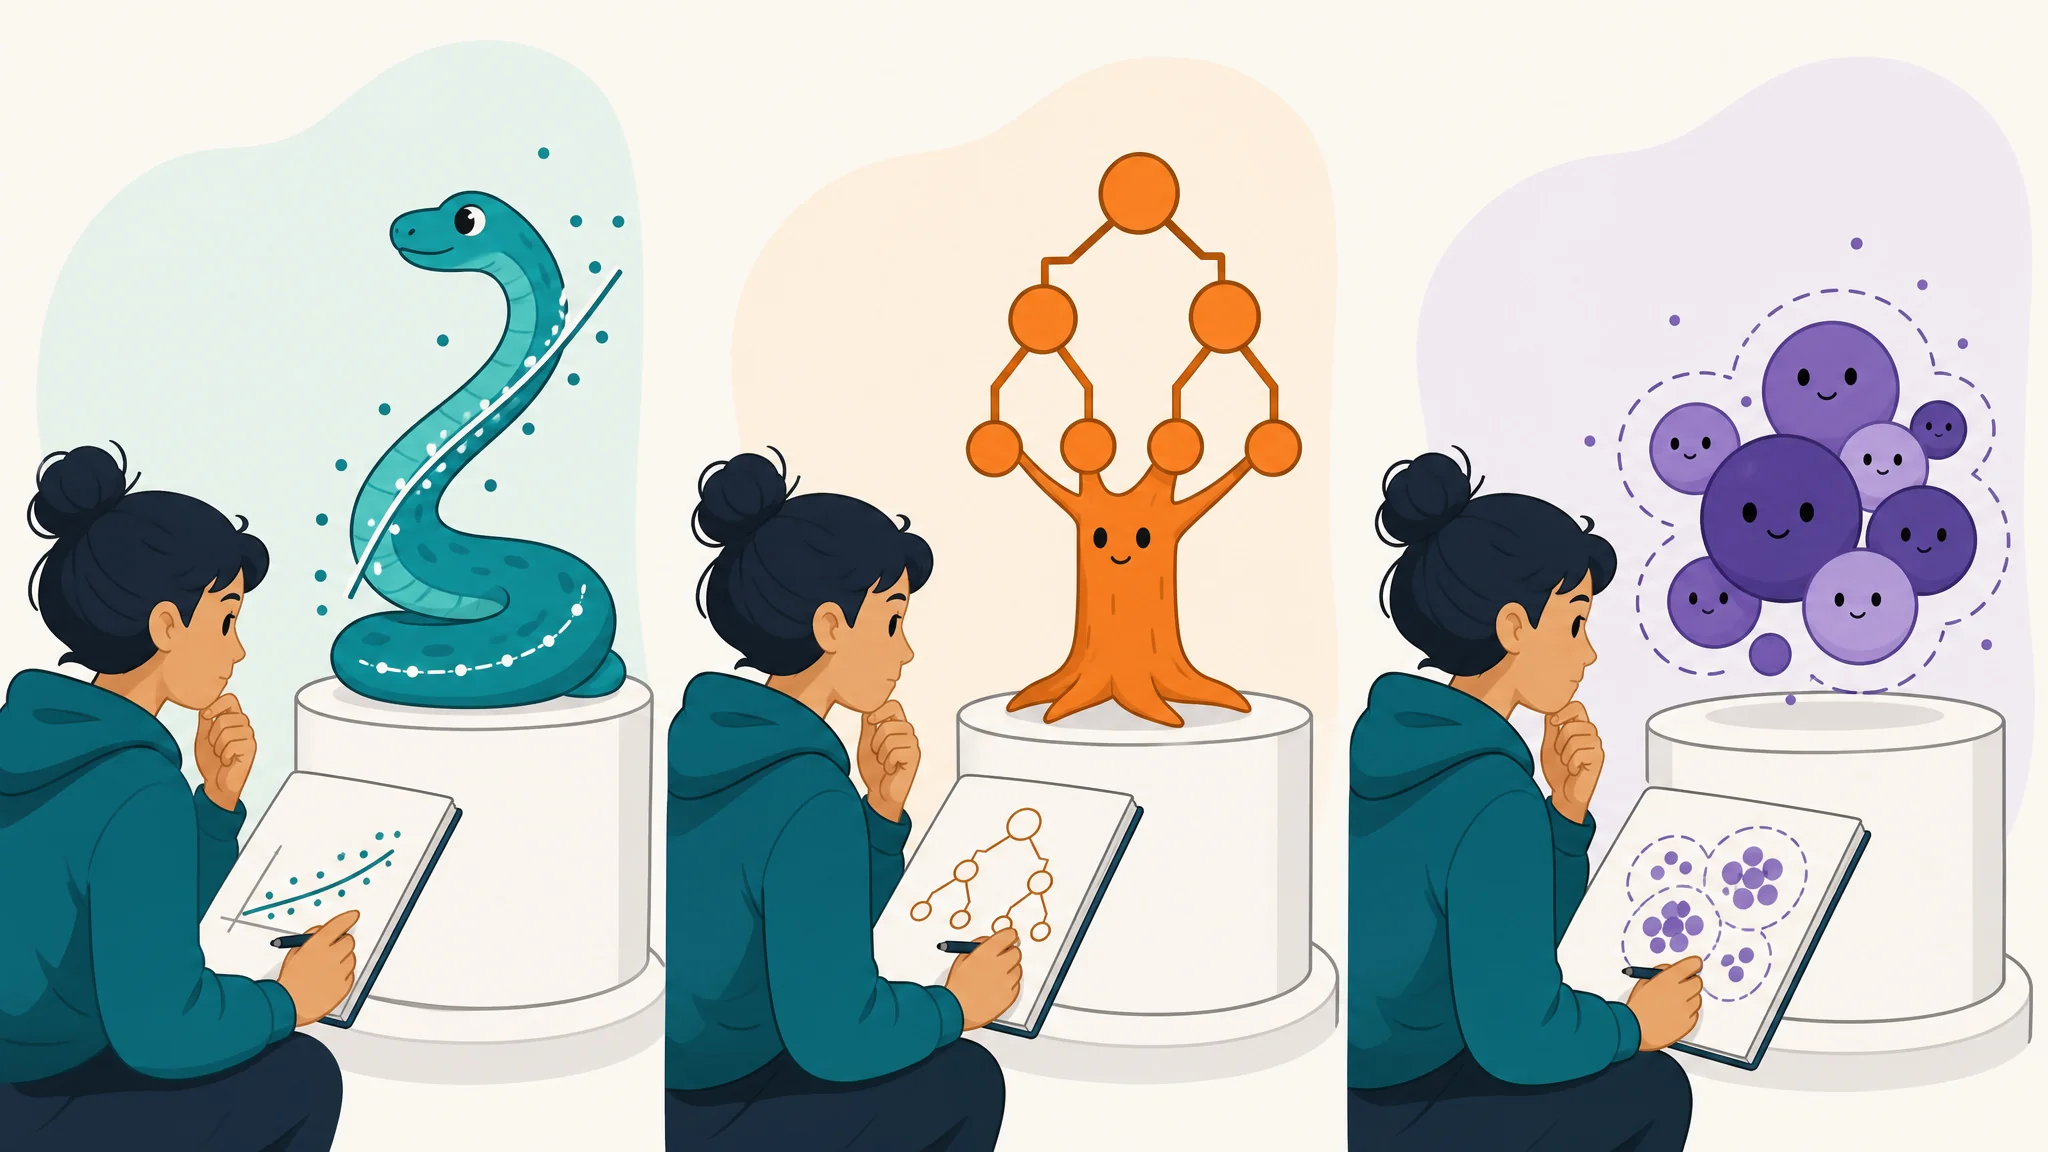

简单说:ai 算法学习从线性回归、决策树、KNN这三个开始,一个管预测数值、一个管规则推理、一个管找相似。用同一批数据把三个都跑一遍,比零散学十个算法记得牢。顺序就是这个名字的先后顺序。
我被ai 算法学习这个词吓住过。打开任何一份教程,算法名单从线性回归一路排到随机森林、支持向量机、神经网络,二三十个起步,每个都配着公式。当时我的反应是关掉页面点了份外卖。后来我换了个学法:别的全不碰,就挑三个,拿同一个问题轮流跑,两周下来居然真入门了。这篇就把我用的那套"一题三算法"的练法完整交出来,问题选的是二手车价格预测,接地气,好理解。
为什么是这三个?因为它们各代表一种思维模型:线性回归教你看"因素怎么加权",决策树教你看"规则怎么分层",KNN教你看"相似的东西价格相近"。机器学习里后来的花活,九成是这三种思路的变奏或组合。地基打好,后面看什么都眼熟。
准备练习数据:二手车价格数据集去哪找
原子答案:练手首选公开数据集,Kaggle上有现成的二手车价格数据,含车龄、里程、品牌等字段;想极简就自造五十条的玩具数据。先把数据备齐再学算法,学的时候手上有料。
具体路径说细点。Kaggle的二手车价格数据集几千条记录,字段有年份、里程、变速箱类型这些,够真实也够干净。不过我给新手的建议是先别用几千条,自造一份五十行的玩具表:拉上三五款车的信息,年份、公里数、卖价,Excel里十分钟的事。玩具数据的好处是你能心算验证——这车比那车旧三年、多跑两万公里,价格差多少,模型算出来的数你自己能判断靠不靠谱。几千条的真实数据留到第二周再上,先建立手感再说。
工具用Python加scikit-learn,scikit-learn的线性模型文档是我当时的主要参考,示例代码改改就能跑。零基础装环境怕翻车的,从零跑通第一个小项目那篇有装环境的保姆级流程,亲测避坑。
第一个啃线性回归:ai 算法学习的起手式
原子答案:线性回归假设价格和各因素是简单的加权关系——车龄折多少钱、每万公里折多少钱,学出这套权重就能预测。它是最该先学的算法:可解释、算得快、是无数模型的祖宗。
用二手车讲最直观。直觉上大家都懂:车每多开一年掉一些钱,里程每多一万公里再掉一些。线性回归干的就是把"一些"精确成数字。我拿玩具数据跑出来过一个结果:每年约折价八千,每万公里约折价五千,品牌另算。看到这组数字蹦出来的时候我愣了下——这不就是二手车贩子心里的那本账吗,只不过贩子靠经验,模型靠数据。
它的教学价值无可替代:每个因素对应一个权重,权重正负和大小一眼看懂,你能直接指着说"里程比车龄更伤价"。后面学逻辑回归、神经网络,骨架全是这套加权思想的延伸。练这个算法的坑只有一个:别急着学公式推导,先用,用出感觉再回头补数学,顺序反了容易劝退。这是我在AI入门学习最大的误区里踩过的坑,血泪经验。
第二个啃决策树:像老司机一样问问题
原子答案:决策树学的是一套提问顺序——先问车龄超没超五年,再问里程超没超十万,一层层问下去落到一个价格区间。它模拟人类专家的判断流程,可解释性三个算法里最强。
线性回归的短板在于只会算加权账,处理不了"超过某个节点价格跳水"这种拐弯逻辑。二手车恰好有:营运车过了六十万公里强制报废,临近这条线的车价断崖式下跌,线性回归对这种断崖完全无感,决策树却是天生干这个的。我造的玩具数据里塞了一条这样的车,线性回归的预测偏高得离谱,决策树直接给出了合理的低位。同一个数据集上两种算法的分歧,比我读十篇科普印象都深。这就是"一题多算法"练法的妙处:分歧点即知识点。
决策树还有个附赠好处:它能输出一棵可以画的树。我把训练出来的树打印成流程图发给一个做二手车的表哥,他扫了两眼说"跟我们收车的问法差不多"。得到行内人认证那一刻,我对机器学习的恐惧基本消散了——原来它学的就是人的经验,只不过学的数据量更大、更不知疲倦。
第三个KNN,压轴讲。它的思路憨得可爱:来了一辆待估价的车,去数据库里找最像它的五辆(年份像、里程像、品牌同),拿这五辆的成交价取平均,就是估价。没有公式推导,没有训练过程,纯靠"查户口"。我的玩具数据上它表现意外地好,尤其对那些配置特殊的车型——加装了天窗真皮这类线性回归抓不住的细节,只要相似车在库里找得到,它就估得准。
KNN的命门也得亲手撞一次才懂:它慢,每次估价都要跟库里所有车比一遍;而且字段一多就犯迷糊,车龄、里程、品牌、排量、颜色全算相似度,重要的字段被不重要的稀释了。这个坑有个学名叫维度灾难,我撞上时不知道名字,只觉得"怎么加了几个字段反而变蠢了",查了资料才对上号。撞坑不丢人,撞完能对上术语,就是学习在发生。想继续往算法深处走的,三个练透之后接算法模型的通关顺序,那里面的名单从线性回归一路排到神经网络,正好承接。
三个算法同台对比:ai 算法学习的一题三跑记录
原子答案:同一份五十条玩具数据上,线性回归、决策树、KNN各有擅场——线性回归稳、决策树能处理断崖、KNN对特殊车准。新手要记的不是谁分高,是各自什么场景出场。
我的对比结果压成表,加了一列主观点评:
| 算法 | 玩具集表现 | 上手难度 | 我的点评 |
|---|---|---|---|
| 线性回归 | 常规车估得稳 | 最低 | 必须第一个学,懂它半个机器学习就懂了 |
| 决策树 | 断崖价抓得住 | 低 | 可解释之王,给老板汇报就用它 |
| KNN | 特殊车最准 | 最低 | 思路最像人,但字段多了就犯傻 |
玩具数据集上的分数看看就好,重点是那张"出场表":规律平滑用线性回归,有拐点用决策树,样本少而杂用KNN。这张表的价值在真实工作里被反复验证过,我后来做销售预测用的是回归系,做用户分群前的探索用的树,思路源头都是这一次的一题三跑。
新手学ai 算法学习最常见的三个错误
原子答案:一贪多,收藏二十个算法的教程等于零;二跳过基础直接上神经网络,地基虚;三只看不跑,看懂和跑通之间隔着一条鸿沟。三个错误我全犯过,解法就一条:三个算法、一份数据、亲手跑完。
展开说贪多这条,最普遍也最隐蔽。收藏夹里躺二十个算法的教程,会产生一种"我在学"的错觉,其实你只是在囤。我的判断标准很粗暴:一个算法没在自己的数据上跑出过结果,就不算学过,连报名费都没交。按这个标准,我第一轮自学归零,第二轮老老实实一题三跑,两周真入门。慢吗?比囤三年教程的人快多了。
跑通之后的进阶也有讲究。别急着加算法数量,先把三个老朋友玩出花:给线性回归加正则化(就是后来的岭回归和Lasso),给决策树组队(就是随机森林),你会发现一票高级算法全是这三个的魔改版。所谓进阶,很多时候是把基础看第二遍。走这条路之前,建议拿学AI到底需要学什么的极简清单校准一下方向,避免在算法之外的地方空耗。机器学习基础概念还虚的,机器学习是什么的白话版先补一课再回来,更稳。
常见问题
ai 算法学习一定要先学数学吗?
不用先学,用到再补。三个入门算法需要的数学,高中水平够撑。我的顺序是先跑通、再回头补公式,理解公式的速度反而更快,因为你知道每个符号对应代码里的什么。
三个算法要学多久?
每天一小时的话,两周能全部跑通。一周一个节奏刚好,别压缩到三天,跑通和想通之间需要一点发酵时间。
练完这三个,下一步学什么?
逻辑回归加随机森林,正好是三个基础算法的两次升级:逻辑回归是回归思想做分类,随机森林是决策树组队。学它们会有大量既视感,顺滑得很。
不用二手车数据,换别的行吗?
行,原则就一条:选你熟悉的领域。房价、身高体重、奶茶销量都行,你对数据的直觉越准,验证模型输出时越有底气。
回头看,ai 算法学习入门这事,难的不是算法,是抵抗住"多学点"的贪心。三个算法、一份数据、两周时间,门槛低到不像话,但走完的人真的不多。我表哥那句"跟我们收车的问法差不多"我一直记着——机器学习学的从来都是人类经验,你缺的只是把它跑起来的那一步。
这篇对你有启发的话,转给那个收藏夹里囤了一堆算法教程的朋友,让TA先把三个跑通再说。