让AI解释AI是怎么学习的,比想象中讲得明白
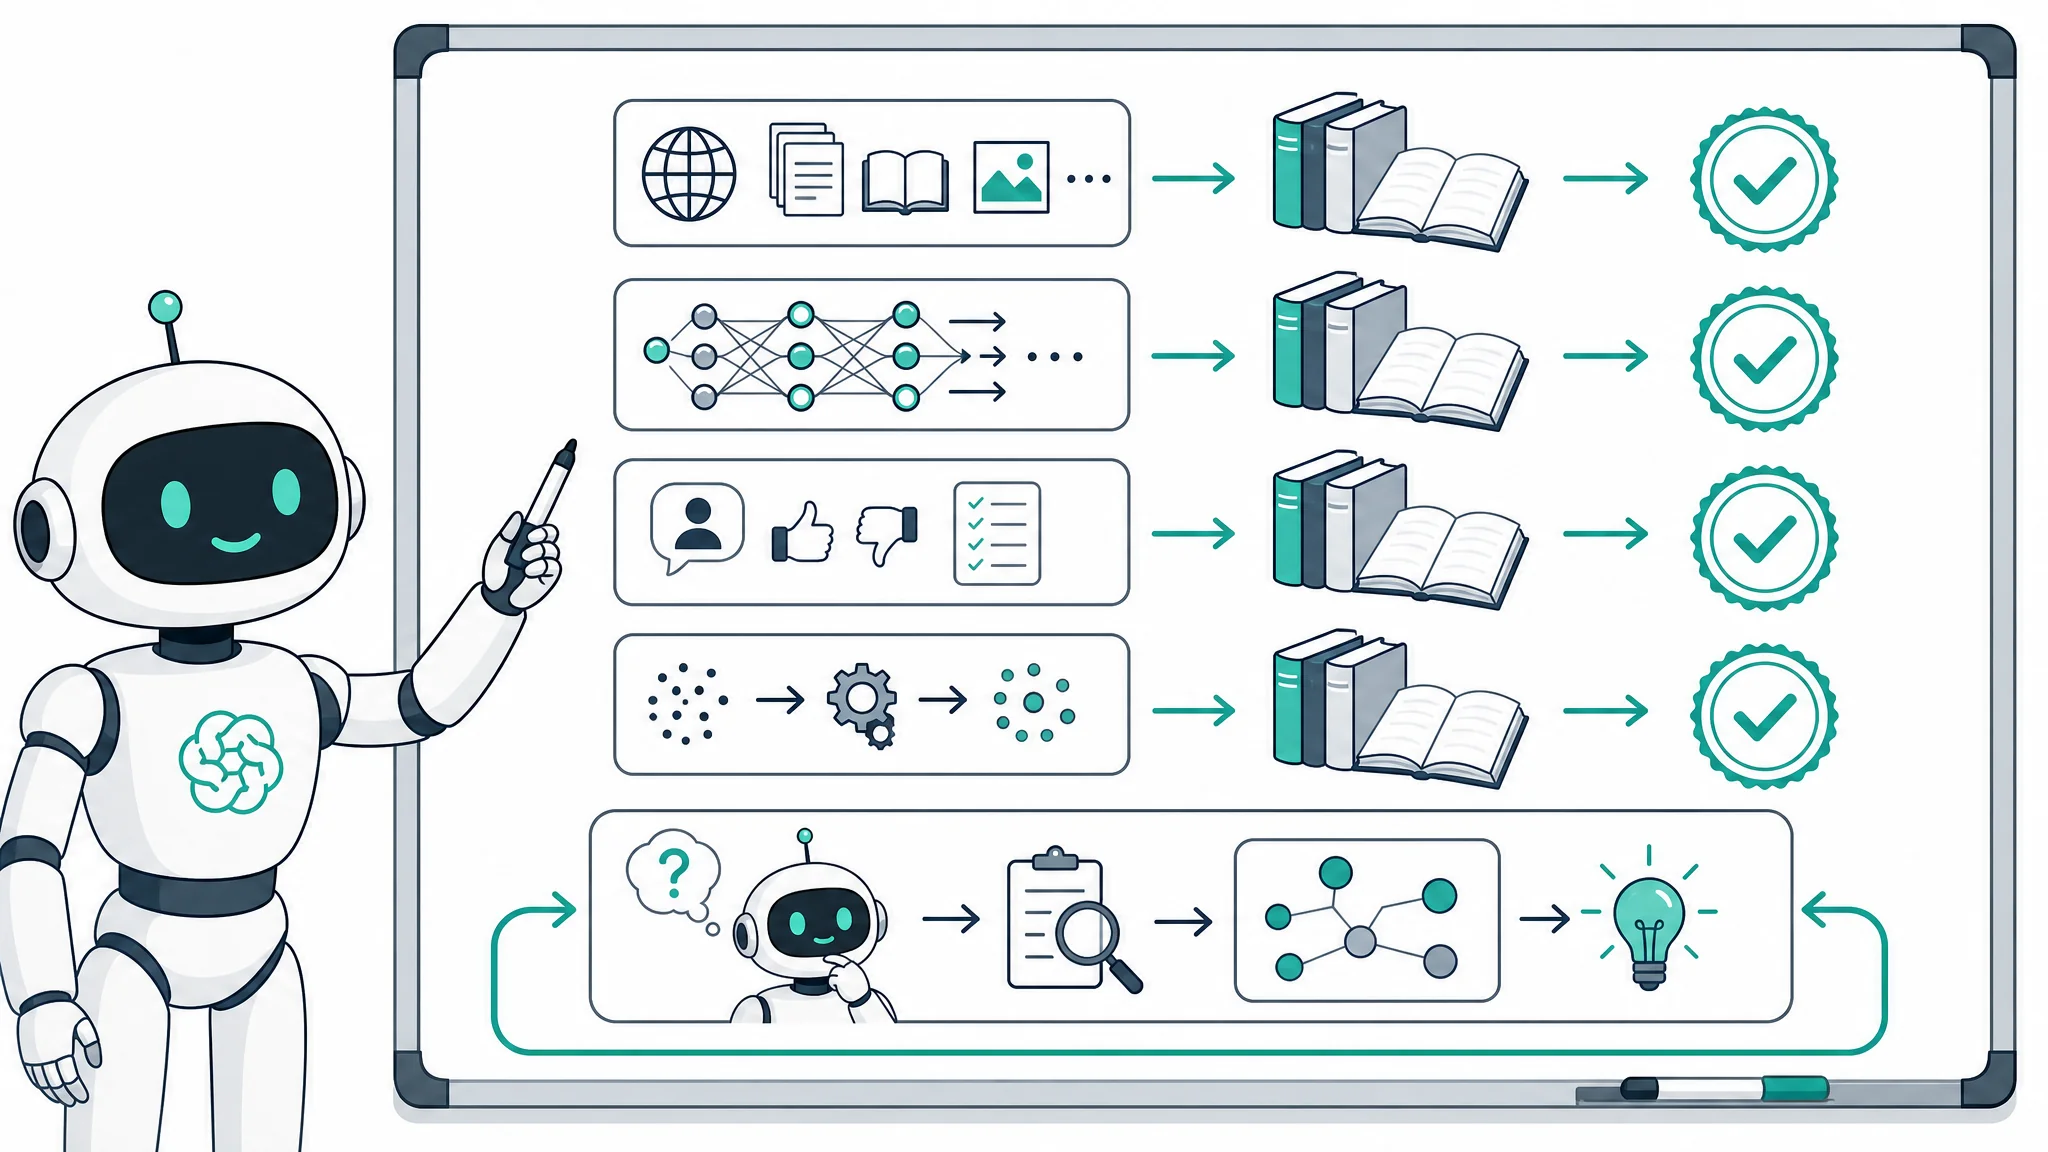

简单说:ai如何学习ai这个问题,让AI自己答,八成说得对,两成在打太极。我把三个模型的回答拆成7条说法,逐条对照官方文档和公开资料验证,4真2含糊1存疑。验证方法比结论更值钱,往下抄就行。
ai如何学习ai这个问题,起因是家庭群里的一场争论。我表弟说AI会自己越用越聪明,我爸说那玩意就是个大号的复读机,俩人吵到我头上。我说我给你们问AI本人。
问完我就后悔了——AI答得太流畅了,流畅到我表弟直接截图甩群里宣布获胜。可我盯着那段回答看了三分钟,心里发毛:这里面到底几句是真的?ai如何学习ai,让AI自己讲自己,这事听起来像让嫌疑人自证清白。但它讲得确实明白,明白得让我起疑。
于是我干了件笨事:把三个模型的回答拆开,一条一条拿公开资料去对。这篇就是完整的验证记录,哪句真、哪句虚、哪句纯编,全标出来。想先补背景的,看这篇AI的学习和你以为的不一样,机器学习入门白话版,我拿它当了验证的底稿之一。
先看AI怎么说:ai如何学习ai的自述原文
原子答案:三个模型对"你是怎么学习的"给出了高度一致的自述,核心就一段话:预训练读海量文本、用预测下一个词的方式调参数、再经人工反馈对齐。说法漂亮,真假后面逐条验。
我的提问原文:"用第一人称讲讲你是怎么学习的,从什么都不会到现在能对话,中间发生了什么。别用术语,讲给你六十岁的亲戚听。"
三个模型(一个国产、一个海外、一个开源)的回答我各截了图,揉在一起大意如下:"我读过数量大到无法想象的文字,训练时我反复做同一个游戏——猜下一句话。猜错了,我内部的几十亿个参数就会被轻轻拧一点。猜了几万亿次之后,我就会'说话'了。后来还有一批人类老师给我的回答打分,我照着分数调整自己,变得更听话有用。"
讲得是真好。"轻轻拧一点"这种表述,我专门学AI的人都不一定想得出来。正因为它讲得好,才更有必要验——编得圆的话术和讲得白的原理,外观上没差别。
逐条验证开始:说法一,AI靠猜下一个词学习
原子答案:真的。这是当前大模型训练的公开底牌,官方文档写得分明,三个模型在这一点上没有说谎。
我拿去对的资料是OpenAI官网的技术科普页和维基百科机器学习词条。两边都白纸黑字:语言模型的预训练目标就是预测序列中的下一个词,猜错产生损失,参数朝减少损失的方向更新。跟AI自述的"猜错了就拧一点"严丝合缝。
细节上它偷了个懒:没提"下一个词"其实是"下一个token",词和token不完全等价。这算表述粗糙,不算撒谎,放过。
说法二:训练时人类老师打分让它变听话?
原子答案:真的,术语叫基于人类反馈的强化学习,主流大模型公开承认都用了这步。AI把自己被调教的过程讲得挺坦然。
这一条验证最顺。OpenAI在2022年发的InstructGPT论文里把流程写得明明白白:人类标注员给回答排序,模型照着学。我表弟关心的问题——"它为啥说话客客气气"——答案就在这步,天生的没有,全是调教出来的。
顺带发现个好玩的:三个模型讲到自己"被人类老师打分"时,措辞都偏谦卑,一个用了"变得更有帮助",一个用了"学会更好地服务"。被谁调教就学谁说话,训练目标刻进了语气里。想想还挺哲学的。
说法三:它说自己"记住的不是原文,是规律"?
原子答案:半真。参数里存的确实不是原文拷贝,但"完全不记忆原文"说过头了——大模型被证实能复述训练数据里的片段,版权官司就是这么打起来的。
这是我最想揪出来的一条。三个模型都强调"我不存原文,我学的是统计规律",姿态很无辜。对照资料:模型确实不是数据库那种存法,可研究者多次演示过,用特定提示词能诱导模型吐出训练数据里的大段原文,2023年有团队从对话模型里提取出过训练语料。存不存和吐不吐,是两码事。
打个比方,它不是复印机,但更像一个背了很多书的实习生,平时给你总结大意,灌到位了也能整段背书。跟自己利益相关的说法,AI也会往对自己有利的方向讲。这点上它跟人挺像的,不是吗。记忆机制再往深挖,可以看AI智能怎么学习新知识,和大脑学习很像又不像。
验证到这儿插个插曲。我爸看我桌上摊着一堆打印的资料,问我搞什么名堂。我说在查AI有没有撒谎。他来一句:"你问它'你撒谎吗',它总不能答'我撒'吧。"老爷子这觉悟,比很多跟风吹AI的人清醒。也提醒了我:验证必须拿外部资料对,不能拿AI证AI,那叫循环论证。
说法四:参数被"轻轻拧一点"是怎么拧的?
原子答案:原理为真,机制它没细讲——靠反向传播算法算出每个参数该拧的方向和幅度,这是深度学习的发动机,AI自述里一笔带过属于报喜不报忧。
"轻轻拧一点"听着温柔,真面目是反向传播加梯度下降,训练一次要在海量参数上算天文数字次的调整。我去翻原理时发现AI还有个毛病:我追问"具体怎么拧",它给我的数学解释里有一步符号写反了,拿我手边的教材一对就露馅。大方向对,细节翻车,这是我这次验证里抓到的唯一硬伤。
这也符合它自述里没提的一点:ai如何学习ai,问原理它是好老师,问公式它是危险学生。想搞懂反向传播的,别全信AI给的推导,配着人写的资料交叉看,比如自动微分的白话拆解就是给非数学背景的人写的。
说法五:它说"我训练完就定型了,不会从对话里学新东西"?
原子答案:真的,而且这是三条自述里最值得普通人记住的一条——你跟它聊一万句,它本体一个参数都不会变,"越用越聪明"是错觉。
这条我重点验,因为它直接判了我表弟死刑。资料结论一致:模型参数在训练结束后冻结,对话不回流训练。你感觉它越用越懂你,多半是两件事造成的错觉:一是上下文窗口里它记住了这场对话,二是产品端的个性化推荐在起作用,跟模型本体无关。
产品文案爱在这上面打马虎眼,"持续学习""与你共同成长"这类话,说的都是外挂功能,不是模型在长本事。我后来专门测过这事,怎么测的写在AI有没有学习能力的训练实验里,训练完的模型搁一个半月,准确率一分没涨。零进步,实测的。
说法六和七:数据规模与"我不是抄的"存疑清单
原子答案:数据规模基本属实,各家训练数据以万亿token计有公开报道可查;"我没抄任何作品"这条没法自证,训练数据来源正是全行业打官司的火药桶,AI单方面撇清不算数。
数据量好验。主流模型的训练规模在技术报告里有数,维基百科相关词条也汇总过,"大到无法想象"不算吹牛。版权那条就难了:多家出版社和媒体对AI公司的诉讼还在拉锯,训练数据里有没有受版权保护的内容,连法院都没判完。AI自己说"没有",证据效力约等于零。我把这条标成"存疑",不是我怀疑它人品,是这事它说了不算。
七个待验证说法的最终成绩单:
| AI的自述 | 验证结果 | 依据 | 我的态度 |
|---|---|---|---|
| 靠猜下一个词学语言 | 真 | 官方文档 | 放心信 |
| 人类打分调教 | 真 | InstructGPT论文 | 放心信 |
| 记住的是规律不是原文 | 半真 | 数据提取研究 | 打个折信 |
| 参数被轻轻拧 | 真但粗糙 | 教材加实测 | 概念可信公式别信 |
| 聊天中不学习 | 真 | 公开原理加自测 | 最重要的一条 |
| 数据规模巨大 | 真 | 技术报告 | 信 |
| 没抄任何作品 | 存疑 | 诉讼进行中 | 它说了不算 |
这次验证教会我的三件事
原子答案:一,AI讲自己原理时大方向可信、细节常翻车;二,涉及自身利益的说法会不自觉往好看里讲;三,验证动作本身五分钟就能做完,值得变成习惯。
最实用的验证三步,抄走就能用:第一步,让AI"列出你刚才说法的依据,标明哪条是公认事实哪条是简化类比";第二步,把它承认的简化点拿维基百科或官网对照;第三步,涉及数字和公式的,必找第二来源。我验7条说法花了两个晚上,第二遍再验别的说法,40分钟搞定。
老实讲,这套方法改变了我用AI的方式。现在AI给我任何"它很确定"的答案,我心里都过一遍这三个问题。不是不信任,是信任要有凭据。怎么把AI当老师又不被带沟里,更细的边界讨论可以看把AI当老师的正确姿势和边界,跟这篇正好是一体两面。
最后交代下表弟那场争论的结局:我把"聊天中不学习"那条验证甩进家庭群,附了实验链接。他回了个"行吧"。我爸补刀:"复读机赢了。"复读机倒也不至于,但这一局,老爷子得分。
常见问题
让AI解释AI的原理,它会不会故意美化自己?
会,但不是有意的。它的回答倾向由训练和对齐过程塑造,讲自己时措辞普遍偏谦卑偏正面。规律是:技术原理类大方向可信,涉及自身短板和争议的说服力要打折,版权这种连人类都没吵明白的事,它的单方说法参考价值有限。
普通人的验证工具就维基百科和官网,够用吗?
够用,而且是最优解。官网讲自家产品的口径最权威,维基百科有引用链接可以继续往下挖。别拿短视频当依据,AI科普翻车重灾区就在那。英文资料看着吃力的话,让AI翻译完再对照中文报道交叉一下,两个独立来源对上才算数。
AI说的数学推导错了,还敢用它学机器学习吗?
敢,但换个用法。让AI负责搭直觉和理解框架,公式和推导过手一遍教材或人写的讲义。我在反向传播上翻过车,换来这条铁律。入门机器学习先建立正确概念的顺序,可以参考不写公式讲明白机器学习。
为什么三个模型说得几乎一样,是串通好的吗?
不是串通,是同源。主流大模型的训练方法和语料高度趋同,讲同一个原理自然给出近似的比方。这反而方便验证:三个模型说法一致再对照公开资料一致,这条基本就钉死了。真出现说法打架的知识点,那才是要重点盯的雷区。
整篇验证做下来,我最大的感受不是"AI不可信",恰恰相反——它七条说法里四条经得起查,比很多人类自媒体的科普干净多了。问题从来不在AI说得多,在我们懒得验。
下次再有人拿AI的原话跟你抬杠,别急着信也别急着反驳,把这篇的验证三步走一遍。要是这份数据你用得上,转给那个还在跟人争"AI会不会自己变聪明"的朋友,一张成绩单顶十句嘴仗。