AI与强化学习什么关系?用打游戏就能讲透
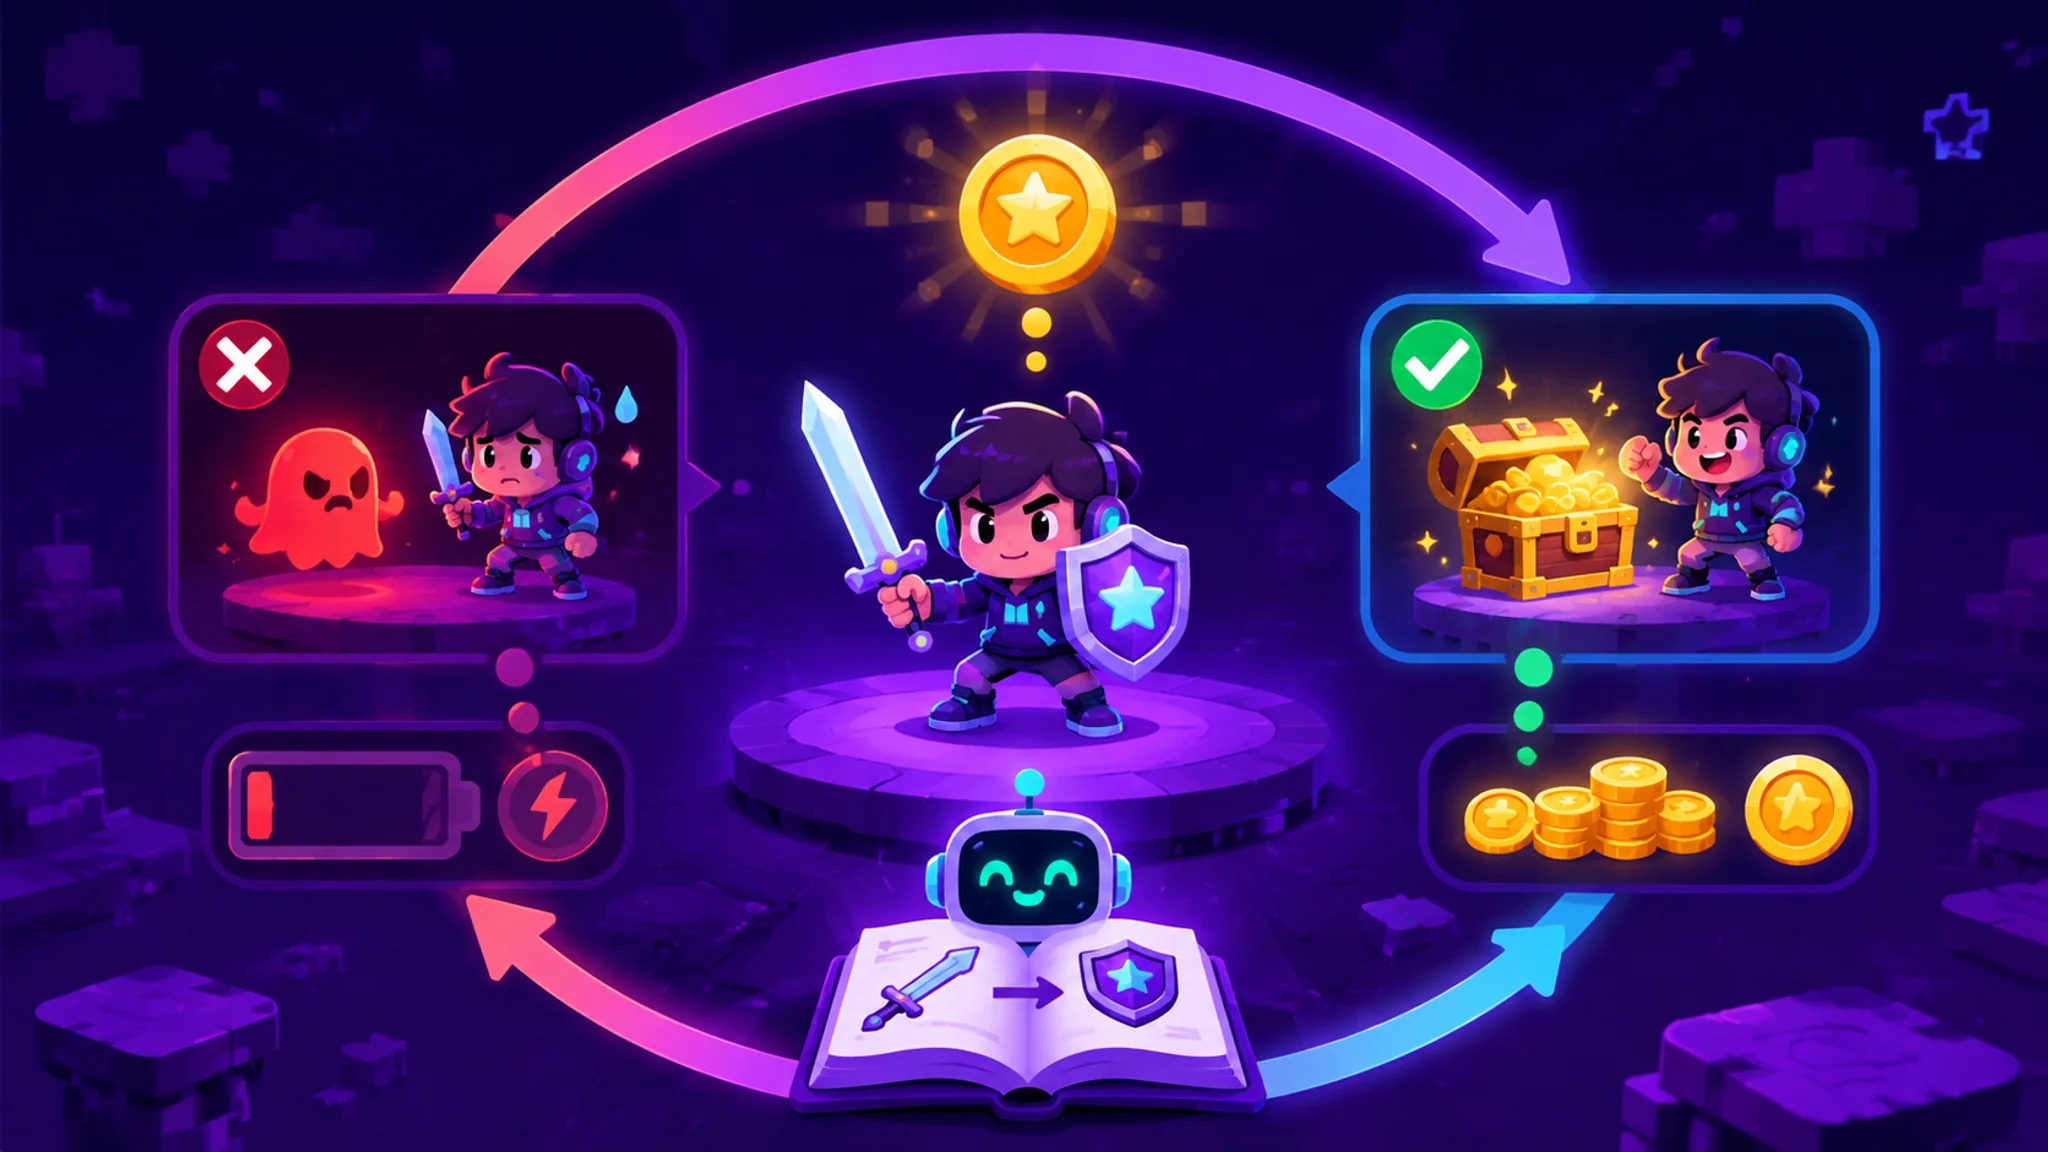

简单说:AI是目标,强化学习是达成目标的手段之一。它让AI像打游戏一样,做对了给奖励、做错了扣分,自己试出最优打法。想直观理解,跑一个CartPole小车demo,二十分钟就能看到AI从乱晃到稳住的全过程。
搞懂ai与强化学习的关系,从一个游戏画面开始。屏幕上有个小人,左边是金币,右边是陷阱。第一局它乱走,掉坑,游戏结束。第一百局,它进化的路线开始绕开陷阱。第一万局,它捡金币的路径精确得像开了挂。没人教过它"往左走两步再跳",它全靠自己试出来的。这就是强化学习,AlphaGo下赢李世石用的也是这一套。AI是大概念,强化学习是里面一个分支流派,专管"没人给标准答案、靠环境反馈自己学"的场景。关系就这么简单。
我第一次真正理解它,不是看论文,是去年自己跑了个demo。后面会把过程写出来,代码不长,翻车点倒不少。
AI与强化学习,到底谁包含谁?
原子答案:AI是"让机器表现聪明的"总目标,下面有好多实现路线,强化学习是其中一条。它和监督学习、无监督学习并列,专攻"边做边学"的任务。训练小狗坐下用的就是强化学习逻辑。画个层次就明白了。AI是最大那个圈。圈里有机器学习,机器学习里又分三大家:监督学习(给带答案的题海)、无监督学习(给一堆没答案的数据自己找规律)、强化学习(不给答案,只给环境反馈)。三兄弟里强化学习最像人学骑车,没人能靠背口诀学会骑车,摔几次就会了。这个层次关系我之前写过一篇更细的,AI和机器学习的层次图,配合着看更清楚。
一句话记法:监督学习是刷题,强化学习是打游戏。
游戏里的奖励机制,就是强化学习的全部骨架
原子答案:强化学习五个件套——智能体、环境、动作、状态、奖励,游戏里全能对上号。你操控的角色是智能体,游戏画面是状态,按键是动作,分数是奖励。全部逻辑就一句话:哪种按键组合得分高,就多按哪种。拆开看打游戏这件事。你玩俄罗斯方块,屏幕上当前的方块形状和堆叠情况,就是"状态";你按左按右还是旋转,是"动作";消行加分、顶到天花板扣命,是"奖励";你这个人,是做决策的"智能体";游戏机就是"环境"。强化学习干的事,是把这套反馈循环丢给AI,让它自己玩上几万局。
关键是"奖励延迟"这个坑。俄罗斯方块里,把方块堆高的决定当时不扣分,祸根二十步后才爆发。AI要学会"现在的选择影响很久以后的得分",这是强化学习最难也最迷的地方。学过下围棋的朋友应该有体感:布局阶段的妙手,价值在中盘才兑现。AlphaGo当年碾压人类靠的就是把这个延迟算明白了。顺带说句,训练它自我对弈的思路,我在游戏AI怎么自学成才那篇里拆过,感兴趣的可以串着读。
说个我自己的糗事,帮你理解奖励有多容易设计错。前年我拿强化学习模板训一个"小人走迷宫",奖励设成"每走一步加0.1分"。结果AI学出一个骚操作:站在原地左右横跳刷分。它没毛病,是我给的奖励机制有洞。真实研究里这种翻车多了去了,行话叫"奖励黑客"。挺离谱的吧?可这就是强化学习的本性:它不领会你的意图,只伺候好你给的分数。
我跑通CartPole的记录:二十分钟看到AI学会平衡
原子答案:CartPole是强化学习的"Hello World"——控制小车左右移动,别让杆子倒。我的实测:训练约200回合后AI就能稳稳撑住,全程代码不到30行,新手第一次跑通成就感极强。记录一下过程,你照着做也行。环境用的开源库Gymnasium,一行pip装好,Gymnasium官网有完整文档。任务描述起来很土:一辆小车上立了根杆子,杆子往左倒你就把小车往左挪,往右倒就往右挪,杆子撑住每一步得1分。就这,看着简单,人手动玩都未必稳。
我的实测时间线:第1回合,AI纯随机,杆子平均撑0.8秒就倒。第50回合,开始有点"扶"的意识,平均撑4秒。第200回合上下,出现一次撑满500步满分。到第400回合,十次测试里八次满分。中间我犯了个错:学习率设太大,分数曲线上蹿下跳,后来调小一半才稳定上涨。调参这事儿,容错率低得吓人。整个过程最震撼我的,是看着那个分数曲线从乱麻变成一条爬升的线——那不是代码在变好,是它真的在"学"。
入门强化学习,别一上来啃数学。先跑通CartPole,再跑FlappyBird类环境,公式放到需要时再回头补。相关路线展开写过一篇,见用打游戏学会AI思维。
强化学习离你有多近:这三个东西全是它撑的
原子答案:你每天刷的内容推荐、游戏里的电脑对手、大模型训练后期的对齐环节,背后都有强化学习。它不遥远,只是穿着别的马甲。逐个说。短视频的信息流排序,早期大量用了强化学习思路:把你的点击和停留当奖励,推荐策略当动作,越刷越懂你。游戏AI对手就更直接了,《星际争霸》的AlphaStar、《Dota2》的OpenAI Five,全是强化学习堆算力堆出来的, OpenAI官网还能翻到当年的技术报告。第三个最容易被忽略:现在的大语言模型,训练后期都有一道"人类反馈强化学习"(RLHF)工序,简单讲就是让人类给回答打分,模型照着分数调整自己的说话方式。你跟AI聊天觉得它"懂事",功劳簿上有强化学习一笔。
想上手学,路线给你排好了
原子答案:先跑demo建立体感,再学Q-learning这种最老的经典算法,最后碰深度强化学习。顺序反了会劝退,亲测。我当年顺序就反了,先啃了两天深度Q网络的论文,看得脑仁疼,差点弃坑。正确姿势:第一步,装好Python,跑通Gymnasium的CartPole,不求看懂每行代码。第二步,把Q-learning的小例子手敲一遍,格子迷宫那种,五十行以内。第三步,读一篇入门综述,建立地图感。第四步,再上深度强化学习。每一步卡住了就退回上一步,别硬顶。学习顺序这件事对不同基础的人影响巨大,之前写过学前想清楚的5件事,抽空看看能少走弯路。基础概念没过关的,先补机器学习白话版也来得及。
常见问题
强化学习和监督学习到底差在哪?
差在有没有标准答案。监督学习的每道题都有正确标签,强化学习只有事后的分数反馈,动作对不对当时没人告诉你。一个是刷题,一个是闯关。
零基础能直接学强化学习吗?
能跑demo,难学透。跑CartPole只需要会装Python库,可要理解背后的贝尔曼方程,得先有概率和机器学习底子。建议先懂监督学习再入这个门,坡度缓和很多。
强化学习学了能干什么工作?
主要去向是推荐系统、游戏AI、机器人控制和大模型对齐团队。岗位数量不如开发岗多,门槛也高,当第二技能比当主业更稳。
为什么强化学习训练要玩几万局,人玩几十局就会了?
人有先验知识,看到杆子倒就知道该往哪边挪,AI连这个常识都没有,全靠撞出来的数据填。几万局就是它补常识的代价,一点不冤。
写这篇翻出了我不少当年的跑码记录,挺感慨的。要是看完你也想开个环境跑一局,或者终于把这俩概念分清了,把文章转给同样在学AI的朋友,比转段子有用。