红警3的AI是怎么思考的?游戏AI行为逻辑拆解
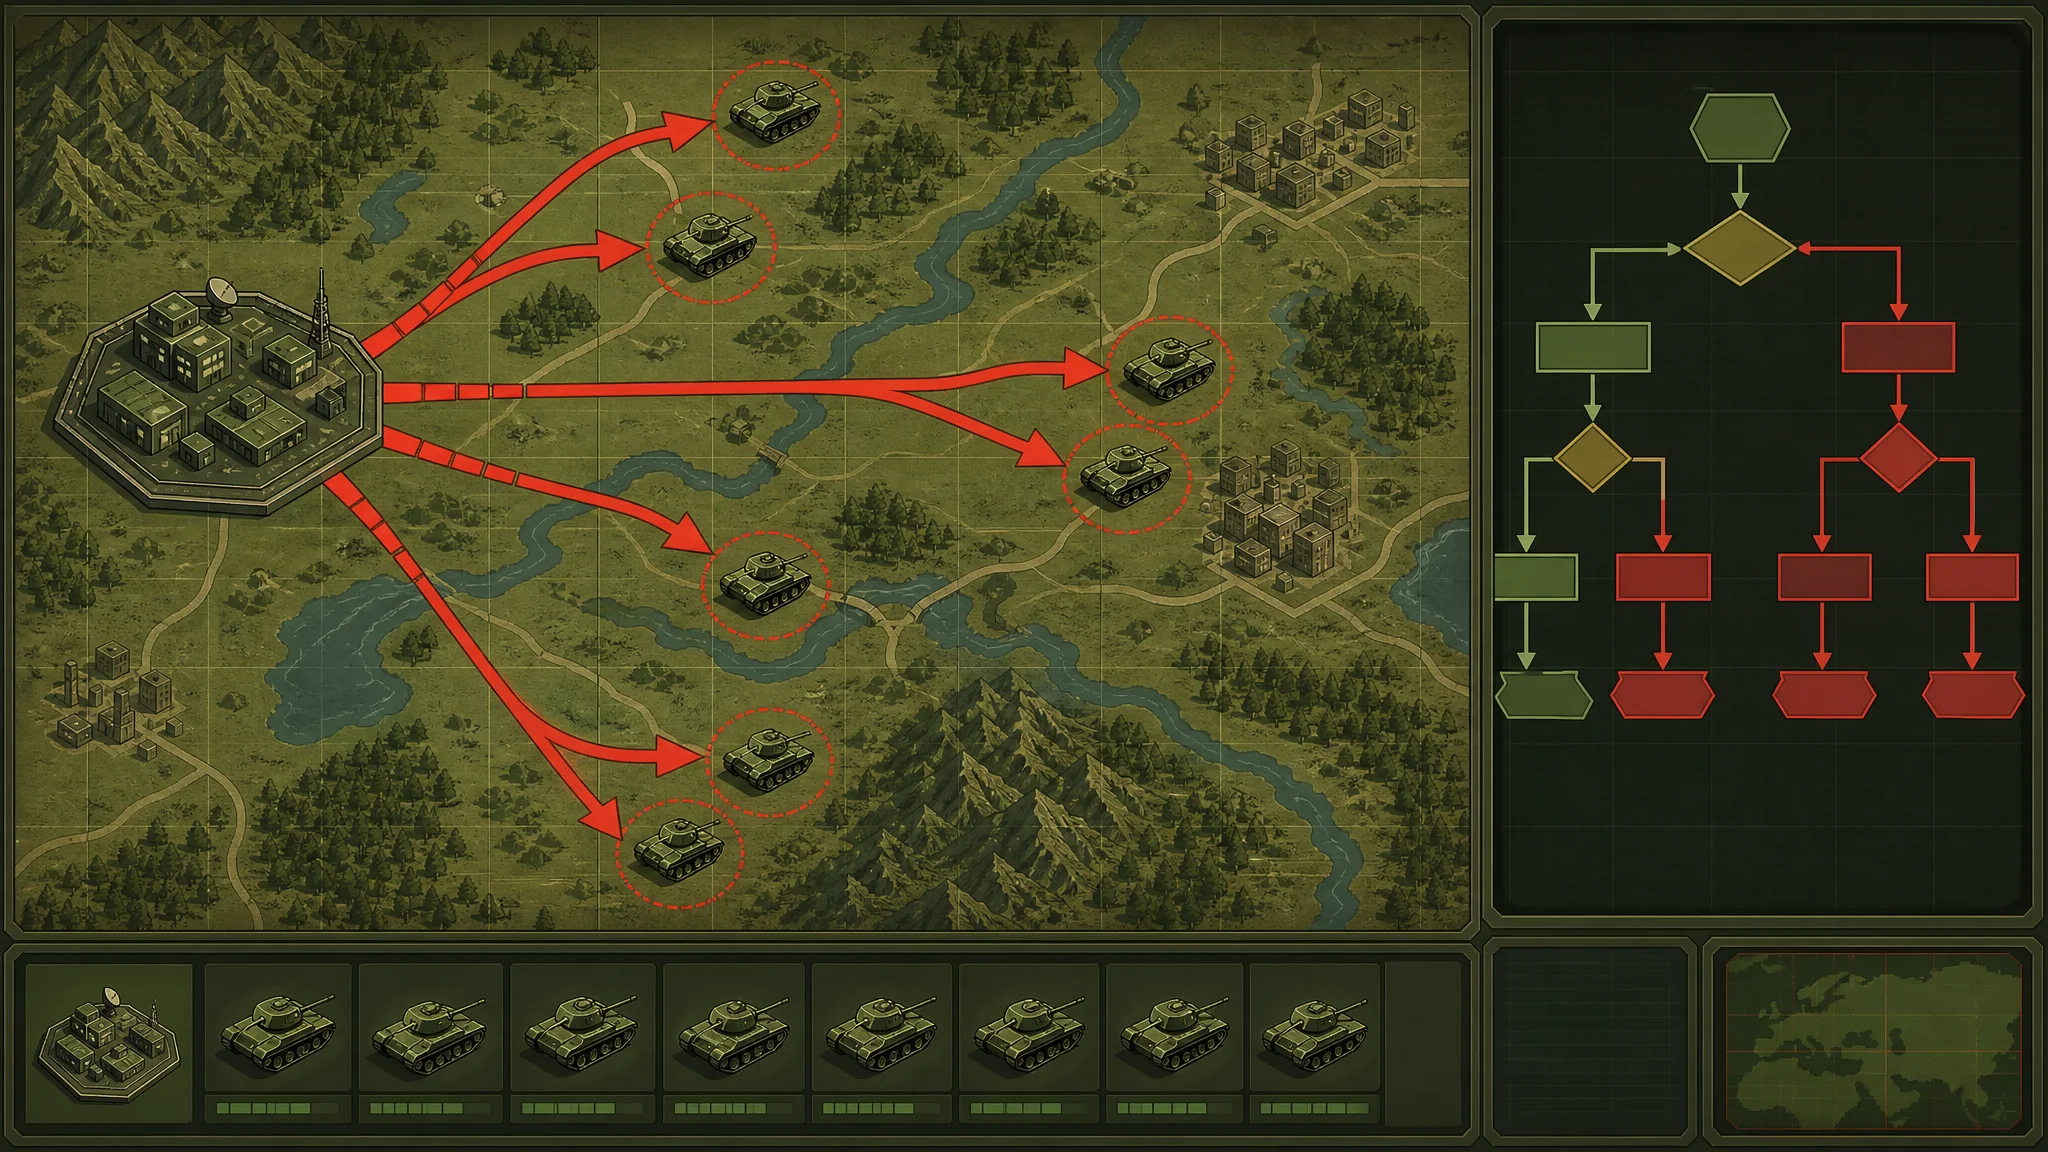

简单说:红警3的AI不思考,它查表。资源分配、出兵选择、战术切换全靠开发组预写的行为树和权重表运转。看懂它的优先级规则,冷酷难度也能被你预判,这才是红警3 ai学习最有价值的部分。
说起红警3 ai学习,我是从输棋开始的。这游戏我断断续续玩了十几年,最上头的一段是前年冬天:连着三周每晚跟冷酷电脑打两局,输多赢少。不服气,我开始录像复盘——不是复盘我自己,是复盘电脑。它的矿车什么时候补第二辆、维和轰炸机为什么总精准砸我的电厂、海啸坦克为什么在我基地车展开的第十秒准时出现在视野边缘。拆了二十多场录像之后我发现,这个2008年发售的RTS,它的AI是一套精心伪装过的规则机器。这篇就把拆解过程摊开,顺便聊聊这些发现对我后来理解人工智能的启发。对,玩红警3 ai学习这事,我是认真的。
红警3的AI开局前90秒:一张写死的优先级清单
原子答案:AI开局行为是固定脚本:造电厂、兵营、补第二矿车、探路单位出发,顺序基本不变,变的是时间压缩程度。难度越高,脚本执行的经济效率越高,而不是智商越高。我逐帧看录像数过的:中等难度电脑,电厂落地大约在游戏第8秒,第一矿车第15秒出动,第二矿车35秒上下补齐,探路的装甲兵第50秒左右摸到你家门口。冷酷难度呢?同样的顺序,整体提前约三成,因为它采矿有隐性加成。发现这个的那一刻我有点幻灭——我以为在跟一个"对手"下棋,其实在跟一张压缩程度不同的流程表赛跑。这也解释了为什么老玩家能背板速攻:脚本开局的确定性,就是它最大的破绽。你第60秒卡住它探路的牛蛙,它整局的信息获取都会迟滞一拍。关于这类脚本AI和行为树的关系,我在UE4行为树入门里展开讲过,红警3用的就是这套思路的前身。
兵种克制不是聪明,是查表:出兵逻辑的真相
原子答案:AI的出兵决策走"侦察输入查克制表":它扫到你造了天启坦克,就按表提升维和轰炸机的生产权重。所谓智能反制,本质是一张兵种克制映射表加反应延迟。这一条我做了对照实验才敢下结论。同一个地图打三局:第一局我正常混编,电脑出兵五花八门;第二局我只爆天启,从第五分钟起电脑的维和轰炸机就没停过;第三局我全程憋空军,它转头狂出牛蛙船和米格。反应延迟也测了:我从开造到第一台天启上线,电脑大约110秒后开始调整生产线。也就是说,它"看到"你的部队构成后,查表、加权、排队生产,全程约两分钟。利用这个延迟,卡着它切换生产线前的一波Timing打出去,胜率肉眼可见地涨。我那三周的胜率从38%拉到70%,靠的不是手速,是读懂了那张表。这种设计哲学在RTS里一脉相承,帝国时代3的AI逻辑更复杂些,我拆在帝国3AI行为分析里了,感兴趣的对照着看。
最颠覆我认知的是它的"战术表演"。冷酷电脑会多线佯攻:主力压正面,三辆海啸坦克绕后偷矿车。一开始我以为这是高级战术推理,后来在一场测试图里发现真相——地图的每条进攻路线在编辑器里被标记了权重,AI按权重轮询派兵,佯攻只是轮询结果撞上了多路线。它没有"骗你"的意图,只是行为的输出看起来像骗你。挺浪漫的,一堆if和权重表,凑出了心理战的观感。我第一次意识到,智能这东西,观感和机制是两回事。后来读机器学习的资料时这个感受反复被印证,入门的线头我放在用打游戏讲透强化学习里了。
| 我观测的行为 | 背后的机制 | 我的应对 | 实测效果 |
|---|---|---|---|
| 开局按部就班 | 固定顺序脚本 | 背板速攻卡时间点 | 胜率明显提升 |
| 精准炸我电厂 | 建筑价值排序表 | 电厂分散布置 | 佯攻损失减半 |
| 针对我出反制兵 | 克制表+约110秒延迟 | 卡Timing抢先手 | 三周胜率四成到七成 |
| 多线绕后偷矿 | 路线权重轮询 | 矿区放一队防御 | 经济断档基本消失 |
从红警3 ai学习看游戏AI:规则机器的天花板
原子答案:红警3这类规则脚本AI的上限是开发组的想象力,不是数据量。它不会从你的战法里学到任何新东西,每一局对它都是全新开局——这也是脚本AI和强化学习AI的分水岭。验证方法很残忍:同一套速攻打同一个电脑十局,人类对手三局后就会针对性布防,电脑第十局还是同样的死法。它没有记忆,没有跨局适应,红警3的AI到底会不会学习这个问题我单独验证过,结论写在红警3AI有没有记忆那篇。但我不觉得这是缺点。2008年的设计团队用确定性脚本换来了两样东西:可调的难度曲线(休闲玩家不至于被虐退坑),和稳定不掉线的本地运算。真正的学习型AI要等到深度强化学习成熟,DeepMind让AI靠自我对弈掌握策略博弈,正是这条路,我复盘在游戏AI怎么自学成才里。游戏AI的设计范式演变资料,英文维基的Video game AI词条梳理得挺全,红警3所属年代的设计套路在里面有迹可循。
把这些发现变成胜率:我的三条实战心法
原子答案:打电脑的三板斧——背开局时间轴压制脚本节奏、用诱饵部队钓出克制表再换兵种、矿区常驻防御断它的轮询骚扰。三条都是利用规则,不是拼操作。展开说说第一条,我最推荐的路子:开一局观战模式(红警3可以开全图视野看电脑),就盯着它的建造序列计时,自己一局不用打,记录二十分钟。第二次上场你手里就有了一张对方的"时刻表",什么时候防空真空、什么时候经济升本,全在掌心。第二条是钓表:故意造两台天启放在它侦察路线(它第50秒的探路单位留下的视野记忆会更新你的兵力构成),引它转产空军,你提前囤好牛蛙等着收。说实话,赢冷酷电脑的爽感一半来自操作,另一半来自这种"我知道你知道我"的算计——虽然它其实不知道任何事。想更系统提升策略思维而不是只背套路的,可以看看用打游戏学会AI思维,思路相通。
常见问题
红警3的AI难度越高是不是越聪明?
不是。难度提升的是资源加成、生产速度和反应延迟缩短,决策框架同一套。冷酷电脑被同一招打死十局的现象,我在正文里实测过,难度改变不了它没记忆这个事实。
红警3的AI能从对局里学习我的打法吗?
不能,它的适应上限是单局内的查表反制,跨局记忆为零。会自我学习的游戏AI是另一条技术路线,细节看我写的AI记忆验证那篇。
为什么我的分矿总被电脑精准偷袭?
因为分矿位置在地图路线上有权重,AI轮询到就近取材。在矿区常驻一队反装甲单位后,我的经济断档基本消失,这招对冷酷难度也管用。
拆解游戏AI对理解人工智能有帮助吗?
帮助很大,而且是教科书给不了的那种:它让你直观看到"规则驱动"和"学习驱动"的边界在哪。当年图灵测试的提出奠定了整个领域的地基,资料在维基百科图灵测试词条,配合游戏AI对照着读,理解会深一层。
十几年前我以为红警3的电脑是个会琢磨我的对手,拆开才发现是一摞精心排布的规则卡片。奇妙的是,懂了这一点之后我反而更敬佩它——用确定的规则造出不确定的观感,本身就是设计功力。这篇拆解转给还在被冷酷电脑虐的朋友吧,告诉他:对面不是天才,是一本你可以翻开看的说明书。